

Faites le grand ménage de printemps de votre RAID : prévenir les défaillances RAID grâce à une liste de contrôle de maintenance des serveurs

Avec le changement de saison, c'est le moment idéal pour redonner un coup de jeune non seulement à votre environnement, mais aussi à votre infrastructure de TI. Le grand ménage du printemps ne se limite pas aux espaces physiques : il est tout aussi essentiel pour vos systèmes numériques. Un entretien RAID régulier peut aider à éviter les interruptions de service imprévues, à réduire les coûts à long terme et à protéger votre organisation contre des pannes RAID dévastatrices.
Lorsque votre grappe RAID fonctionne normalement, il est facile d'oublier jusqu'à son existence. Mais comme tout système essentiel, elle a besoin d'une attention régulière. Appliquer une liste de vérification d'entretien des serveurs structurée ce printemps est une démarche intelligente et proactive pour éviter des interruptions coûteuses.
Le rôle de l'entretien RAID dans la prévention des catastrophes
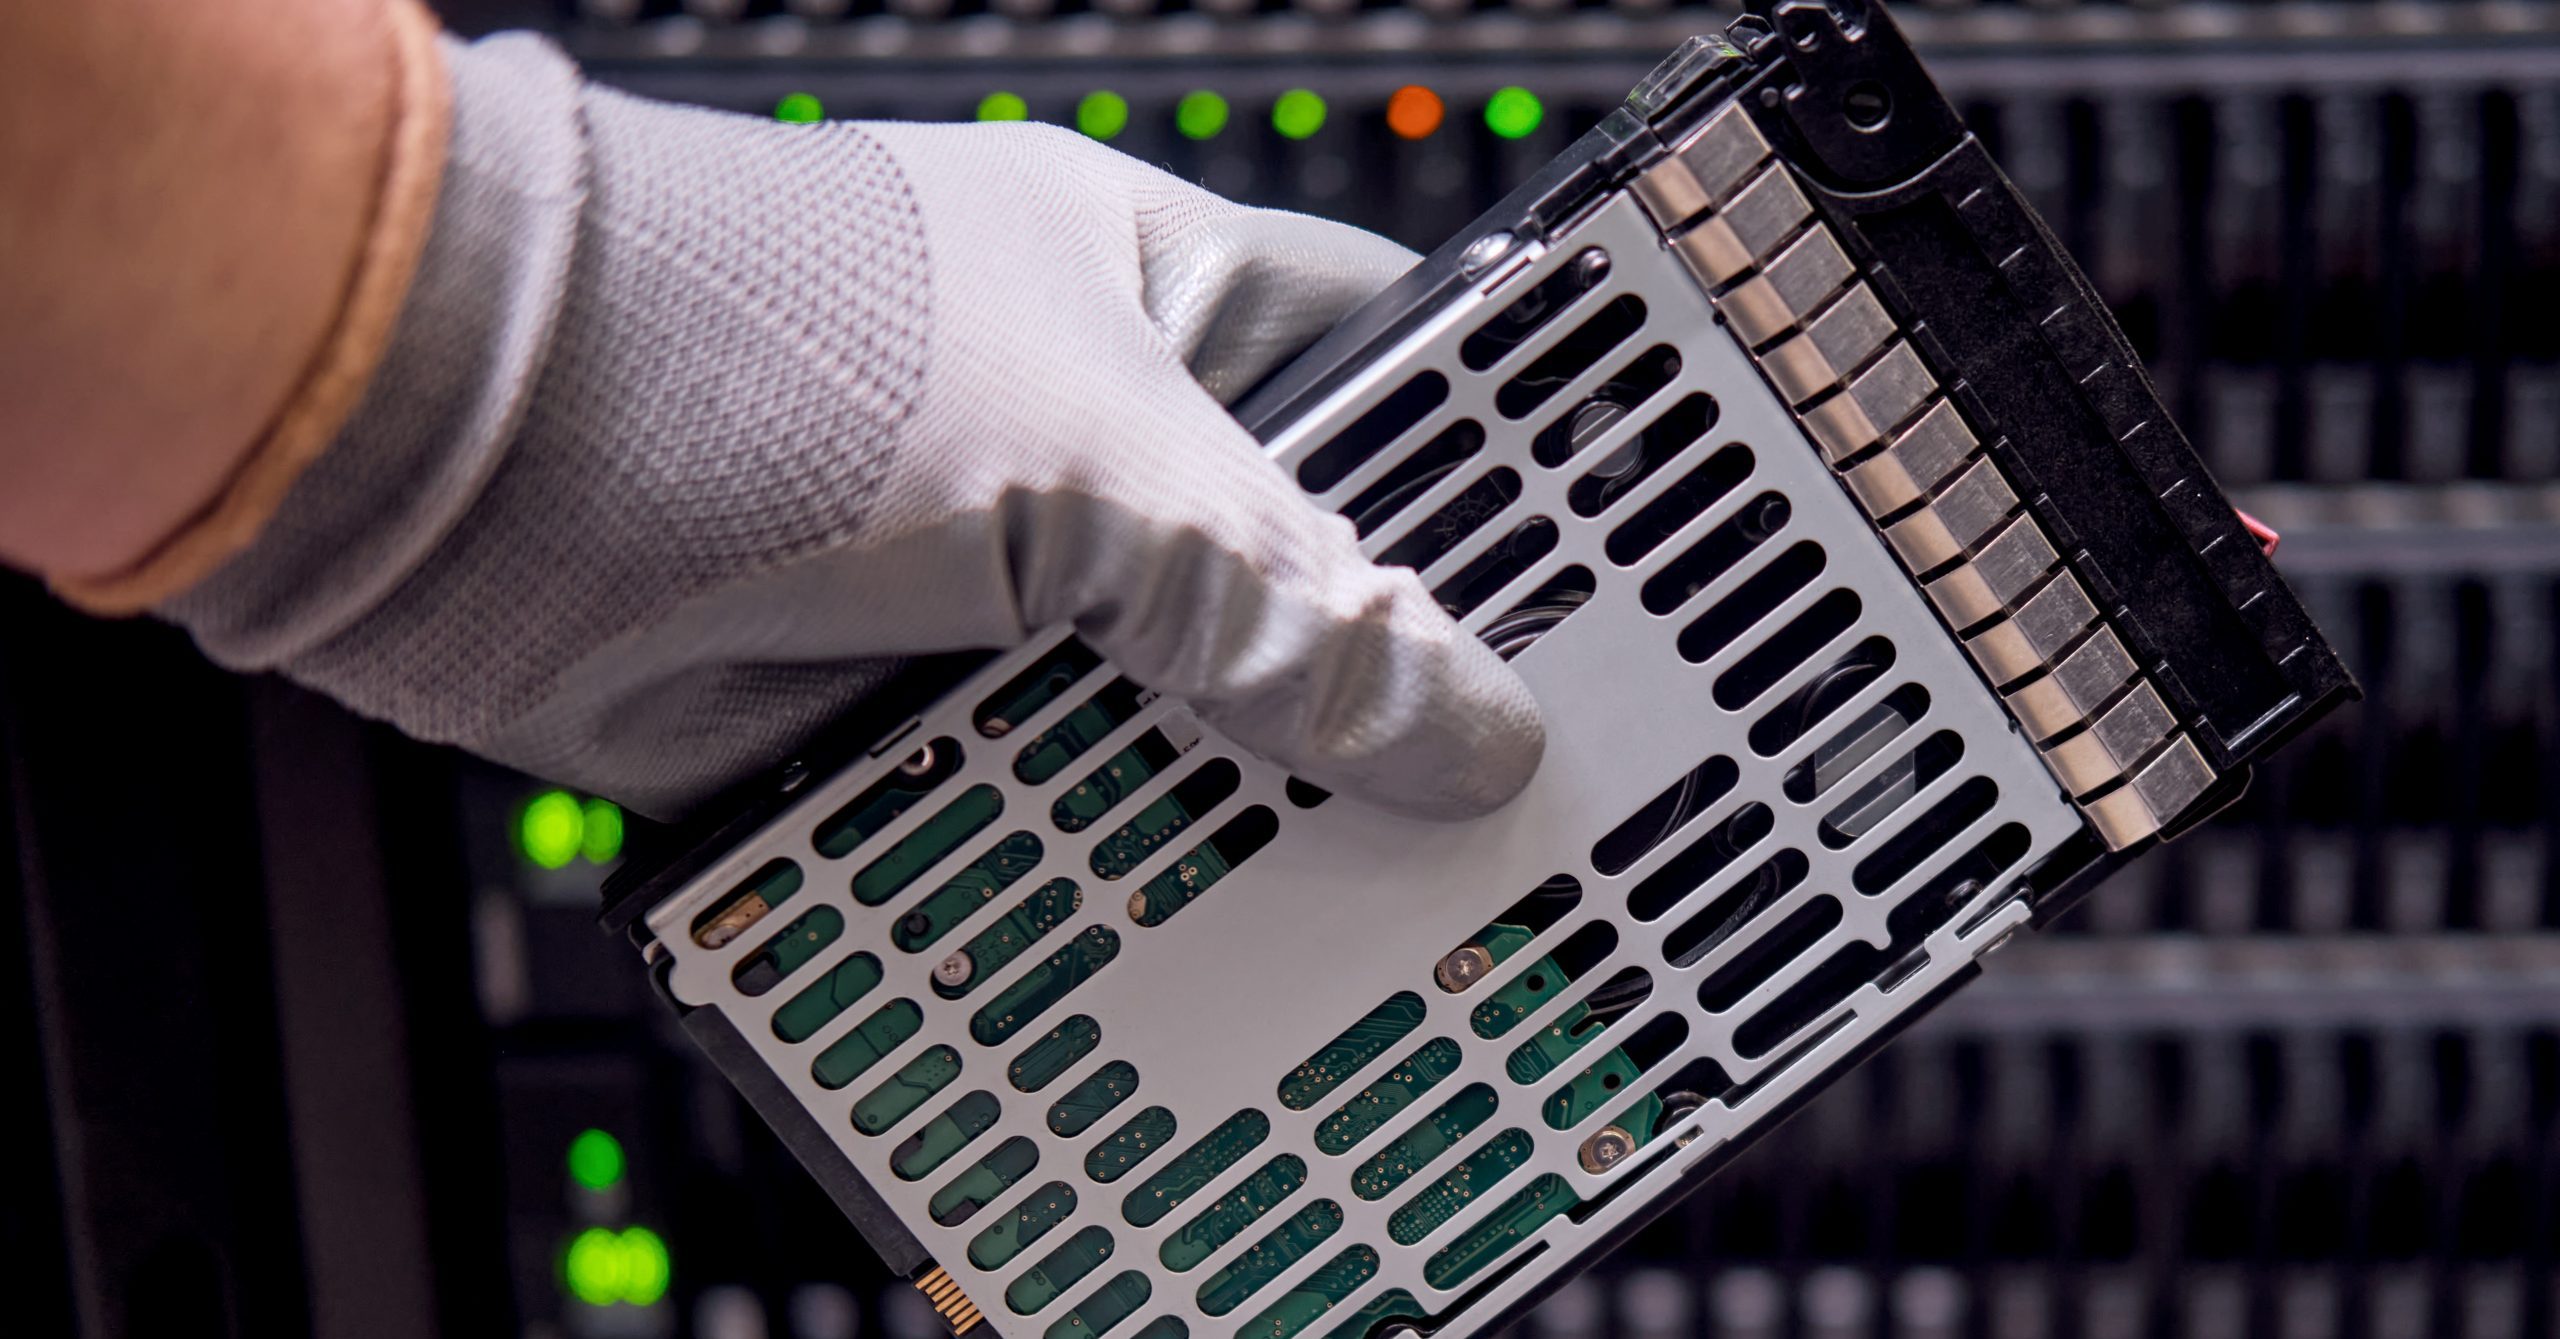
Les systèmes RAID (Redundant Array of Independent Disks, ou grappe redondante de disques indépendants) sont très répandus pour leur rapidité et leur redondance. Mais ils ne sont pas à l'abri des pannes. Sans entretien RAID régulier, même les configurations les plus robustes peuvent se dégrader avec le temps, entraînant des baisses de performance du serveur, voire des pannes complètes de la grappe.
Les grappes RAID peuvent masquer des défaillances de disques pendant un certain temps, en fonctionnant en mode dégradé sans aucun avertissement. Cette dégradation silencieuse ne devient souvent critique que lorsqu'il est trop tard : lorsqu'un second disque tombe en panne, qu'un contrôleur dysfonctionne ou que le système plante complètement. Sans intervention, ces problèmes peuvent dégénérer en une panne système généralisée, provoquant des interruptions de service à grande échelle. L'entretien préventif permet de détecter et de corriger les problèmes avant qu'ils ne s'aggravent.
Les éléments essentiels d'une liste de vérification d'entretien des serveurs
Une liste de vérification de gestion et d'entretien des serveurs complète doit inclure des vérifications régulières du matériel comme des logiciels. Les tâches suivantes sont essentielles pour protéger votre système RAID :
Surveillez l'état de santé des disques RAID
Utilisez des outils de diagnostic pour évaluer les performances des disques sur l'ensemble de la grappe. Surveillez les premiers signes de défaillance, comme les retards de reconstruction ou la dégradation des disques.
Effectuez des tests de sauvegarde réguliers
Ne présumez jamais que vos sauvegardes fonctionnent. Effectuez des tests de restauration réguliers pour vous assurer que les données sauvegardées sont bien récupérables en cas de besoin.
Mettez à jour les micrologiciels et les contrôleurs
Maintenez à jour le micrologiciel du contrôleur RAID et les logiciels des disques. Un micrologiciel obsolète peut entraîner des problèmes de compatibilité ou laisser des bogues critiques non corrigés.
Maintenez un environnement de serveur idéal
Veillez à ce que les salles de serveurs respectent les normes environnementales. La surchauffe, l'accumulation de poussière ou une mauvaise circulation de l'air peuvent réduire la fiabilité du matériel au fil du temps.
Examinez les journaux et la documentation
Documentez toutes les modifications RAID, tous les remplacements de disques et tous les journaux d'erreurs. Des enregistrements précis peuvent considérablement faciliter le dépannage et les futures opérations de récupération.
| Tâche d'entretien | Éléments à vérifier | Fréquence suggérée* |
|---|---|---|
| État de santé de la grappe RAID | Rechercher les disques dégradés, les grappes défaillantes, les problèmes de reconstruction | Quotidienne / Hebdomadaire |
| Mises à jour des micrologiciels et des logiciels | Contrôleur RAID, micrologiciel des disques, outils de gestion | Au besoin |
| Vérification des sauvegardes | Tester les points de restauration, consulter les journaux des tâches de sauvegarde | Hebdomadaire / Mensuelle |
| Conditions environnementales | Température, poussière, circulation de l'air, stabilité de l'alimentation électrique | Mensual |
| Examen des journaux et documentation | Erreurs de disque, historique des reconstructions, modifications de configuration | Quotidienne / Hebdomadaire |
*Les fréquences indiquées sont des recommandations générales. Chaque environnement est unique : adaptez cette liste de vérification à votre volume de données, à la criticité de vos systèmes et à votre profil de risque.
Un exemple concret de panne RAID
Les fluctuations de tension ou les pannes de courant peuvent entraîner une corruption des données, une dégradation des disques, voire un plantage complet du serveur.
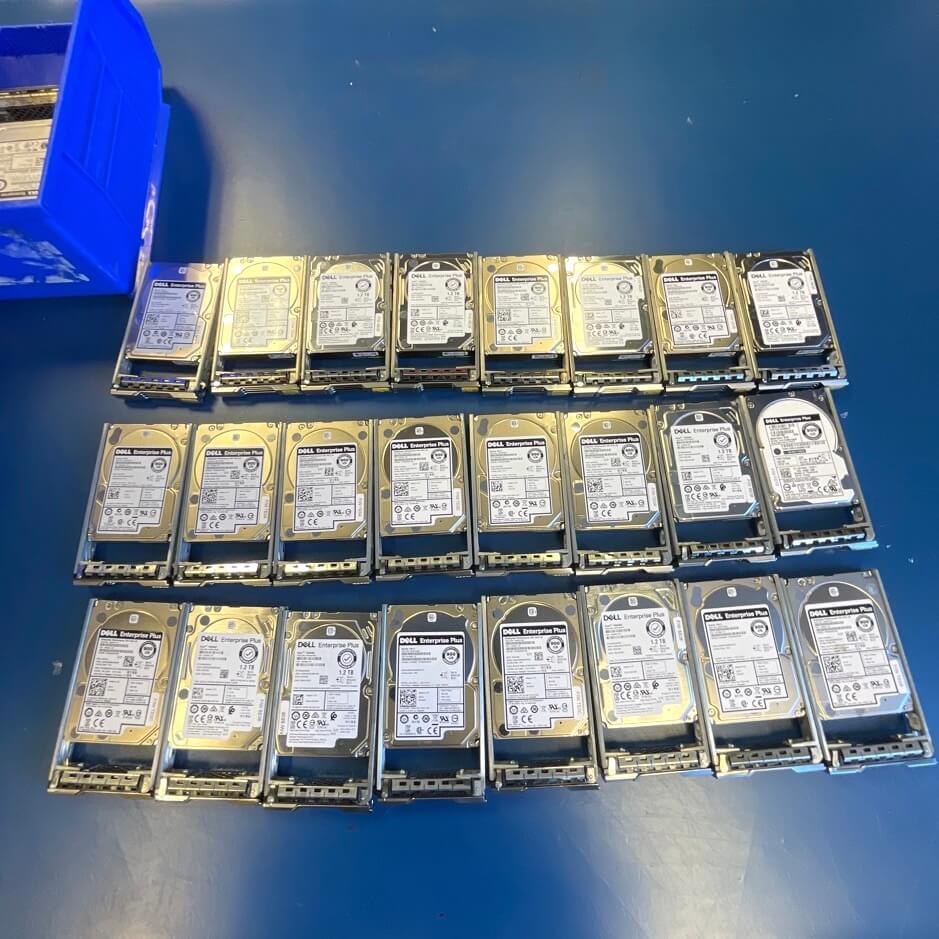
Prenons le cas d'un magasin de vêtements qui a subi la défaillance simultanée de plusieurs disques durs à la suite d'une panne de courant. Son système Dell EqualLogic, composé de 44 disques dans une configuration RAID 50 complexe, a subi une perte de données catastrophique en raison de la panne simultanée de plusieurs disques.
DriveSavers a été appelé pour récupérer les données. Les ingénieurs ont mis au point des outils sur mesure pour interpréter et reconstituer la structure unique du système, et sont parvenus à récupérer la majeure partie des données essentielles du magasin.
Mais même si ce dossier a connu une issue favorable, il nous rappelle clairement qu'une panne RAID peut survenir très vite, surtout lorsque les systèmes sont vulnérables. Dans ce cas précis, un entretien RAID régulier aurait pu réduire considérablement le risque.
Comment l'entretien aurait pu faire la différence
Voyons comment l'issue aurait pu être différente si une stratégie d'entretien proactive avait été en place :
En résumé, une panne RAID est rarement une défaillance isolée. Il s'agit généralement d'une chaîne de petits problèmes passés inaperçus jusqu'à ce qu'un déclencheur externe, comme une panne de courant, fasse basculer le système.
Erreurs courantes d'entretien RAID à éviter
Même les équipes de TI expérimentées peuvent négliger les bonnes pratiques RAID. De plus, les grappes RAID continuent souvent de fonctionner après une ou plusieurs défaillances matérielles, masquant ainsi l'état réel du système. Un seul disque défaillant n'entraîne pas nécessairement l'arrêt immédiat du système, mais il augmente le risque d'une défaillance en cascade des disques sur l'ensemble de la grappe.
Voici quelques faux pas courants qui conduisent souvent à des problèmes :
En cas de panne, faites appel aux experts
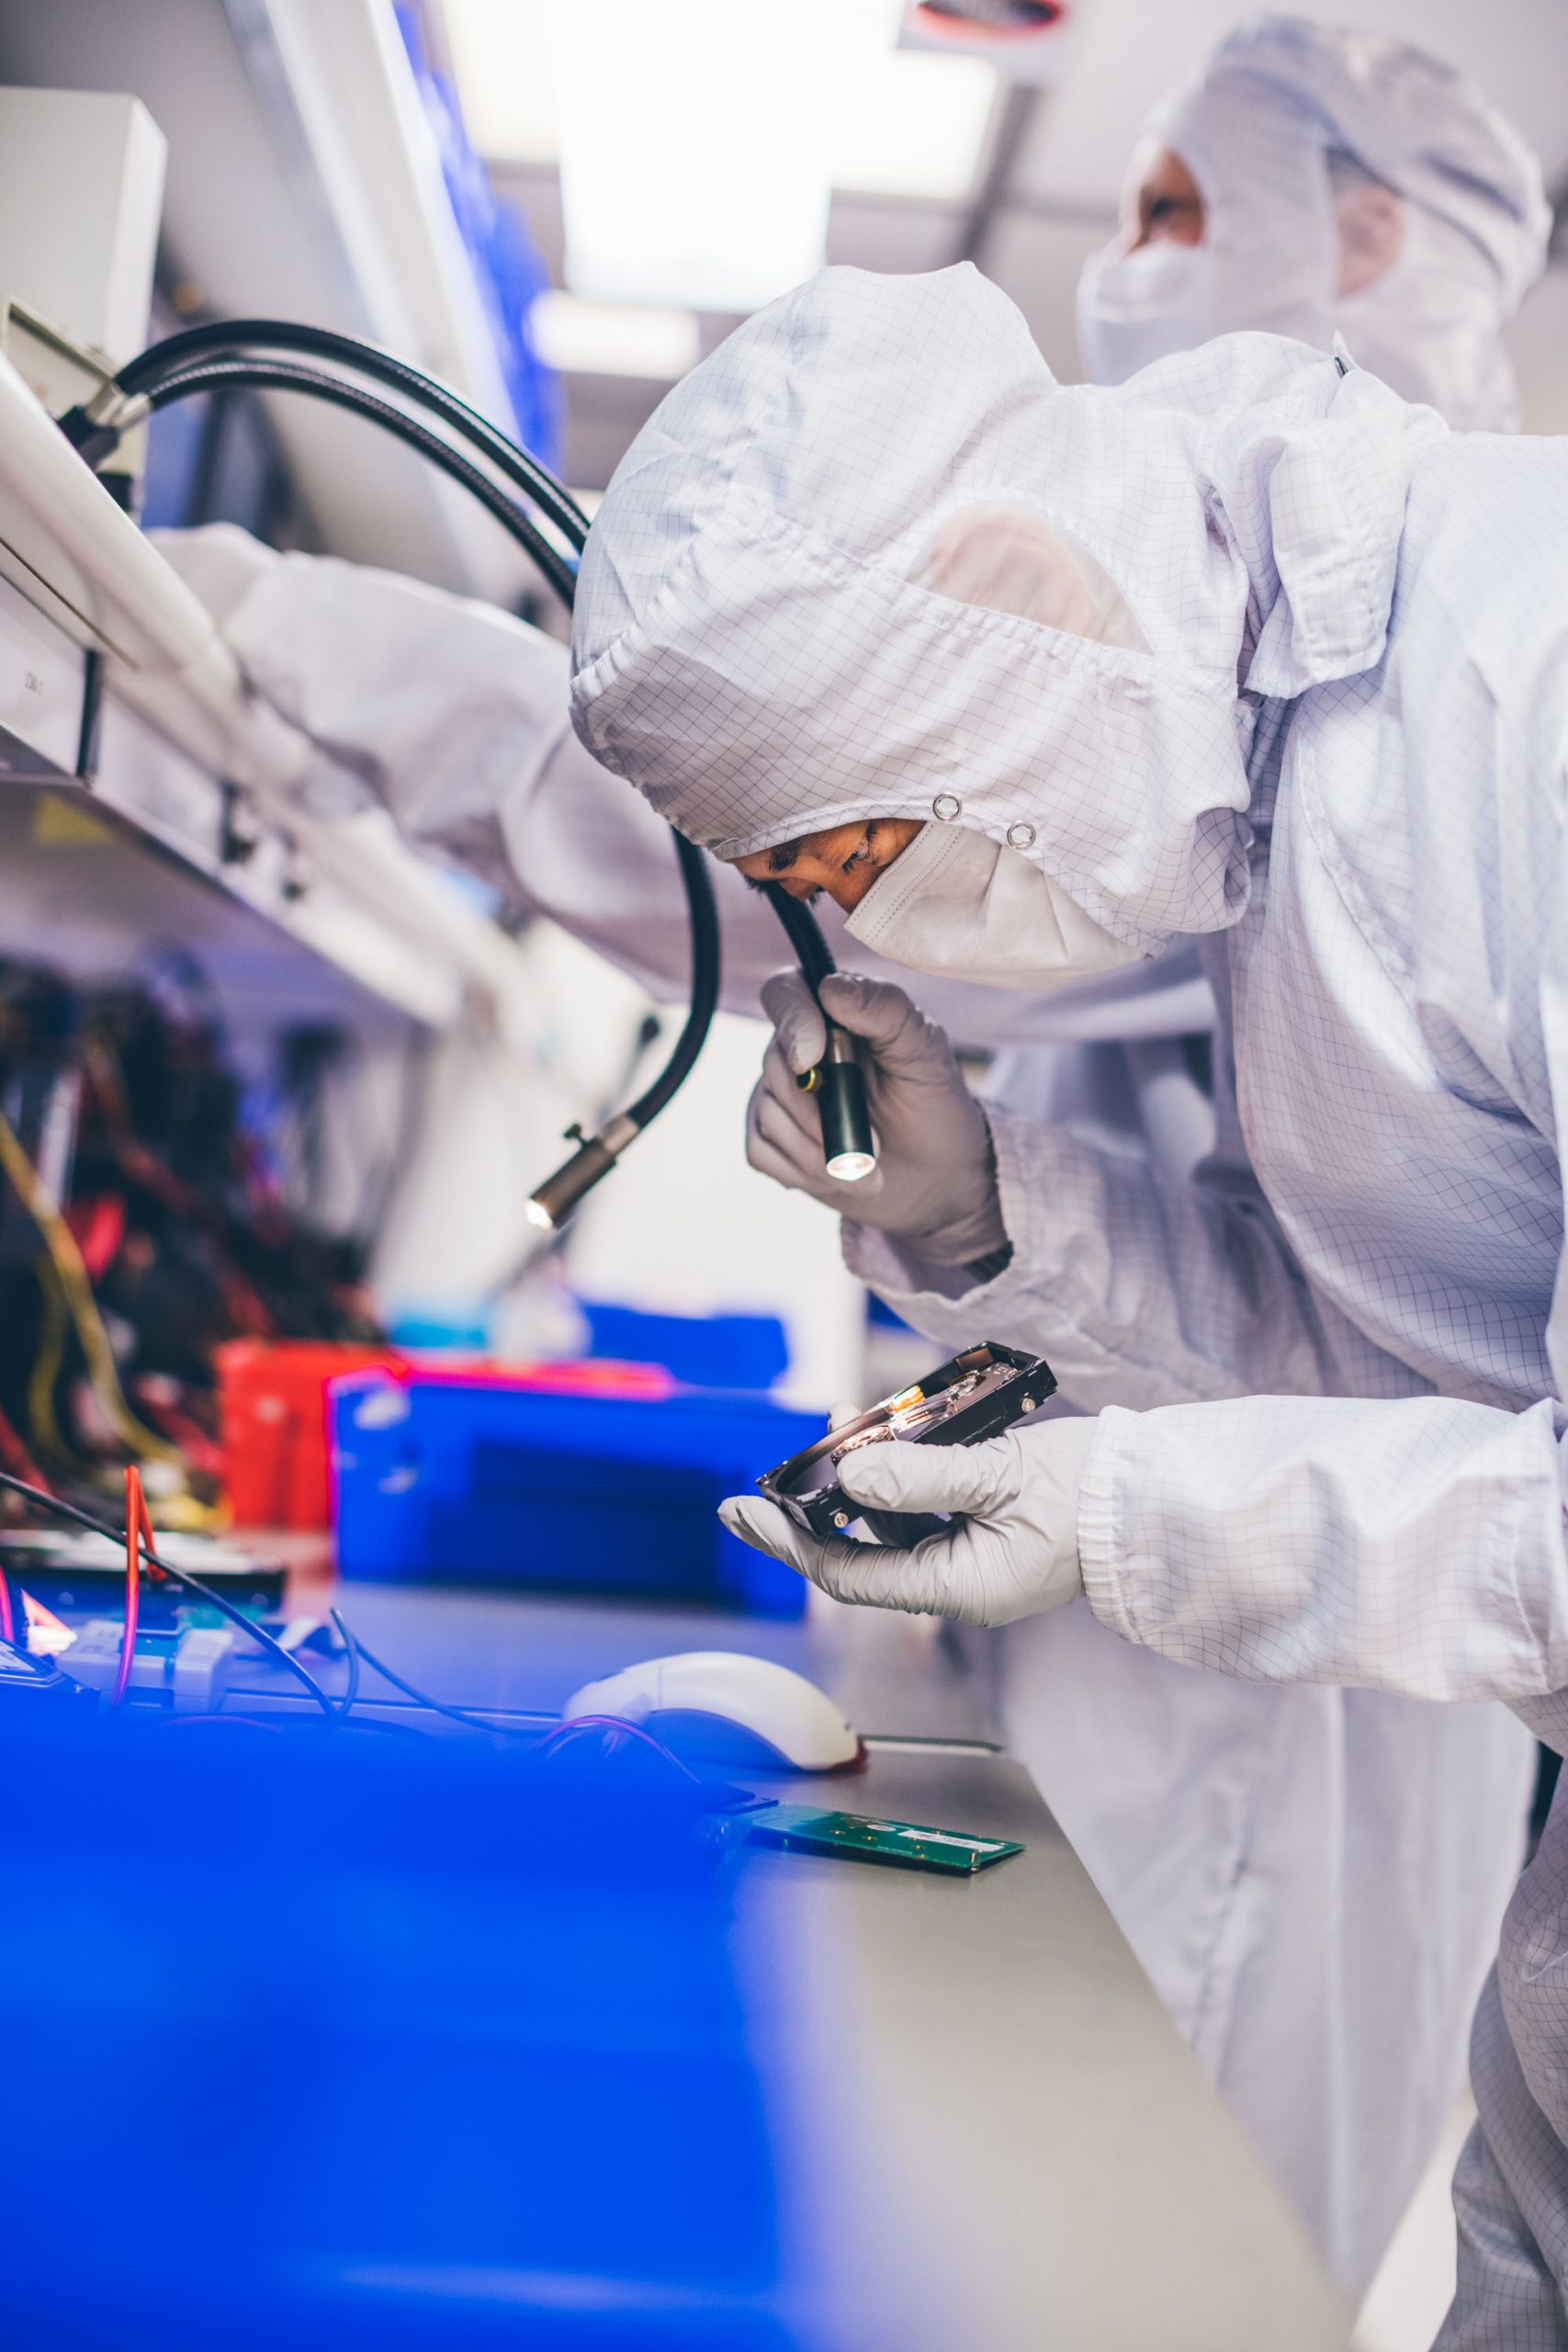
Même avec une planification rigoureuse, des pannes surviennent. Lorsque c'est le cas, il est essentiel de faire appel à des professionnels expérimentés avant d'entreprendre quoi que ce soit. Quelle que soit la solidité de votre plan de reprise après sinistre, l'aide de professionnels peut faire la différence entre une interruption temporaire et une perte définitive.
DriveSavers est depuis des décennies un nom de confiance dans les services professionnels de récupération de données. Nous sommes spécialisés dans les services de récupération de données RAID, de la simple grappe miroir RAID 1 jusqu'au RAID 50 à l'échelle de l'entreprise, et au-delà. Nous avons récupéré des données sur des serveurs endommagés par le feu, des disques gorgés d'eau et des effondrements complets de grappes. Nos ingénieurs travaillent dans des salles blanches certifiées, à l'aide d'outils exclusifs, pour récupérer vos données en toute sécurité, même lorsque d'autres fournisseurs affirment que c'est impossible.
Pour conclure : des systèmes propres, l'esprit tranquille
Le printemps est une période de renouveau, et votre grappe RAID mérite elle aussi un nouveau départ. Négliger l'entretien RAID augmente considérablement le risque de perte de données, ce qu'aucune entreprise ne peut se permettre. Profitez de l'occasion pour vous replonger dans votre liste de vérification d'entretien des serveurs, valider vos systèmes de sauvegarde et évaluer l'état de santé de votre RAID.
Les systèmes RAID sont conçus pour être résilients, mais ils ne sont pas invincibles. Un entretien RAID régulier est l'un des investissements les plus judicieux que vous puissiez faire pour protéger vos données, et votre entreprise, contre des pannes évitables.
Et si la catastrophe survient malgré tout? DriveSavers est toujours là pour vous aider à récupérer ce qui compte le plus. Communiquez avec nous pour obtenir des solutions professionnelles de récupération de données et retrouver vos fichiers rapidement et en toute sécurité.

 English (United States)
 English (Australia)
 French (France)
 English (UK)
 French (Canada)
 English (Canada)
 Spanish (Mexico)
 German
 Dutch
 Italian
 Finnish
 Polish
 Norwegian
 Swedish
 Danish
 Spanish (Spain)
 Chinese
 Japanese
 German (Austria)