

Wiosenne porządki w RAID: zapobieganie awariom RAID dzięki liście kontrolnej konserwacji serwerów

Wraz ze zmianą pory roku to idealny moment, aby odświeżyć nie tylko swoje otoczenie, ale także infrastrukturę IT. Wiosenne porządki nie ograniczają się do przestrzeni fizycznych – są równie ważne dla systemów cyfrowych. Regularna konserwacja RAID może pomóc zapobiegać nieoczekiwanym przestojom, obniżać koszty w dłuższej perspektywie i chronić organizację przed wyniszczającymi awariami RAID.
Gdy macierz RAID działa normalnie, łatwo zapomnieć, że w ogóle istnieje. Ale jak każdy system o krytycznym znaczeniu, wymaga regularnej uwagi. Zastosowanie uporządkowanej listy kontrolnej konserwacji serwerów tej wiosny to mądry, proaktywny krok w stronę uniknięcia kosztownych zakłóceń.
Rola konserwacji RAID w zapobieganiu katastrofom
Systemy RAID (Redundant Array of Independent Disks, czyli nadmiarowa macierz niezależnych dysków) są szeroko stosowane ze względu na szybkość i redundancję. Nie są jednak odporne na awarie. Bez bieżącej konserwacji RAID nawet najbardziej niezawodne konfiguracje mogą z czasem ulegać degradacji, co prowadzi do spadku wydajności serwera lub całkowitej awarii macierzy.
Macierze RAID mogą przez pewien czas maskować awarie dysków, pracując w trybie awaryjnym (degraded) bez żadnego ostrzeżenia. To ciche pogarszanie się stanu często staje się krytyczne dopiero wtedy, gdy jest już za późno: gdy ulegnie awarii drugi dysk, kontroler zacznie działać nieprawidłowo lub system całkowicie się zawiesi. Bez interwencji problemy te mogą eskalować do pełnej awarii systemu, powodując rozległe przestoje. Konserwacja zapobiegawcza pomaga wykrywać i usuwać problemy, zanim wymkną się spod kontroli.
Kluczowe elementy listy kontrolnej konserwacji serwerów
Kompleksowa lista kontrolna zarządzania i konserwacji serwerów powinna obejmować rutynowe kontrole zarówno sprzętu, jak i oprogramowania. Poniższe zadania są niezbędne do ochrony systemu RAID:
Monitoruj stan dysków RAID
Korzystaj z narzędzi diagnostycznych, aby oceniać wydajność dysków w całej macierzy. Zwracaj uwagę na wczesne oznaki awarii, takie jak opóźnienia w odbudowie lub degradacja dysków.
Przeprowadzaj regularne testy kopii zapasowych
Nigdy nie zakładaj, że kopie zapasowe działają. Przeprowadzaj regularne testy przywracania, aby upewnić się, że zapisane dane rzeczywiście da się odzyskać w razie potrzeby.
Aktualizuj oprogramowanie sprzętowe i kontrolery
Dbaj o aktualność oprogramowania sprzętowego kontrolera RAID i oprogramowania dysków. Przestarzałe oprogramowanie sprzętowe może powodować problemy ze zgodnością lub pozostawiać nierozwiązane krytyczne błędy.
Zapewnij idealne środowisko serwerowe
Upewnij się, że serwerownie spełniają normy środowiskowe. Przegrzewanie, gromadzenie się kurzu lub słaba cyrkulacja powietrza mogą z czasem obniżać niezawodność sprzętu.
Przeglądaj dzienniki i dokumentację
Dokumentuj wszystkie zmiany w RAID, wymiany dysków i dzienniki błędów. Dokładne zapisy mogą znacznie usprawnić diagnozowanie problemów i przyszłe działania związane z odzyskiwaniem danych.
| Zadanie konserwacyjne | Co sprawdzić | Sugerowana częstotliwość* |
|---|---|---|
| Stan macierzy RAID | Szukaj zdegradowanych dysków, uszkodzonych macierzy i problemów z odbudową | Codziennie / Co tydzień |
| Aktualizacje oprogramowania sprzętowego i programowego | Kontroler RAID, oprogramowanie sprzętowe dysków, narzędzia zarządzania | W razie potrzeby |
| Weryfikacja kopii zapasowych | Przetestuj punkty przywracania, sprawdź dzienniki zadań tworzenia kopii zapasowych | Co tydzień / Co miesiąc |
| Weryfikacja kopii zapasowych | Temperatura, kurz, przepływ powietrza, stabilność zasilania | Co miesiąc |
| Przegląd dzienników i dokumentacja | Błędy dysków, historia odbudów, zmiany konfiguracji | Codziennie / Co tydzień |
*Podane częstotliwości są ogólnymi zaleceniami. Każde środowisko jest wyjątkowe – dostosuj tę listę kontrolną do wolumenu danych, krytyczności systemów i profilu ryzyka.
Przykład awarii RAID z życia wzięty
Wahania napięcia lub przerwy w zasilaniu mogą prowadzić do uszkodzenia danych, degradacji dysków, a nawet całkowitej awarii serwera.
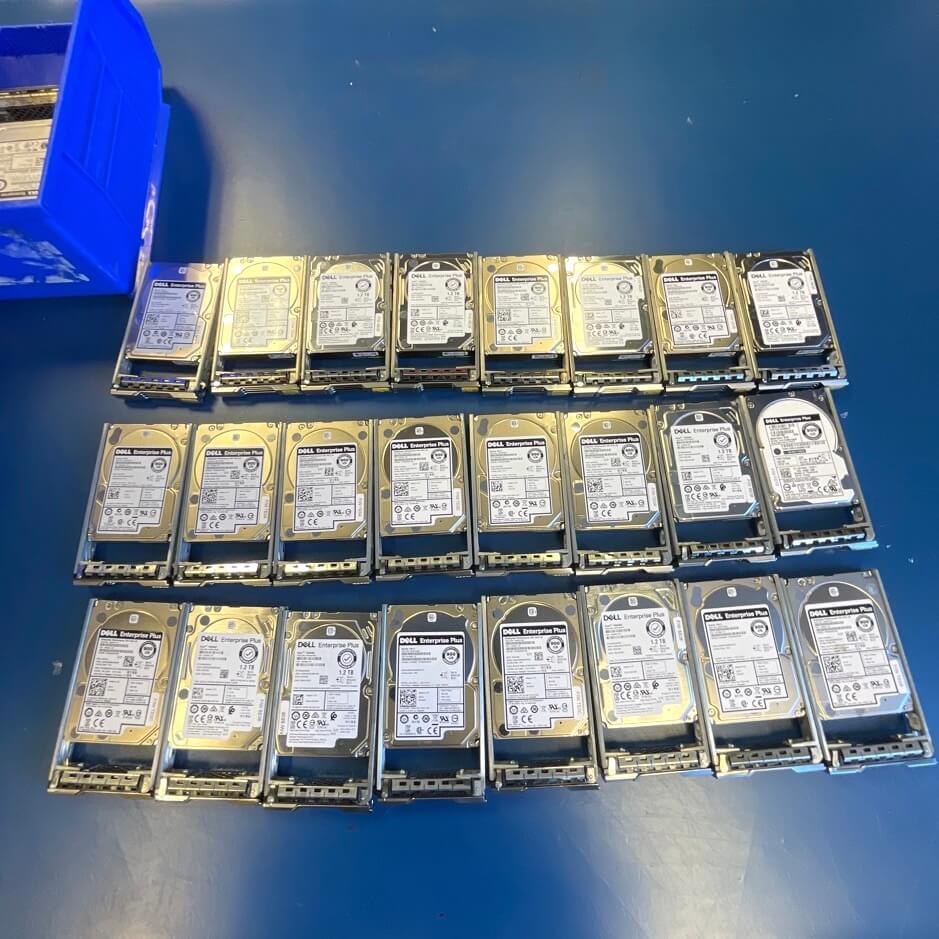
Weźmy przypadek sklepu odzieżowego, w którym po awarii zasilania uległo awarii kilka dysków twardych. Jego system Dell EqualLogic, składający się z 44 dysków w złożonej konfiguracji RAID 50, doznał katastrofalnej utraty danych z powodu jednoczesnej awarii kilku dysków.
DriveSavers został wezwany do odzyskania danych. Inżynierowie opracowali niestandardowe narzędzia do interpretacji i odtworzenia unikalnej struktury systemu, dzięki czemu z powodzeniem odzyskali większość kluczowych danych sklepu.
Choć ten przypadek zakończył się pomyślnie, jest wyraźnym przypomnieniem: awaria RAID może nastąpić szybko, zwłaszcza gdy systemy są podatne na zagrożenia. W tym przypadku regularna konserwacja RAID mogła znacząco zmniejszyć ryzyko.
Jak konserwacja mogła zrobić różnicę
Przyjrzyjmy się, jak wynik mógłby się zmienić dzięki proaktywnej strategii konserwacji:
Krótko mówiąc, awaria RAID rzadko jest awarią pojedynczego punktu. Zwykle jest to łańcuch drobnych problemów, które pozostają niezauważone, dopóki zewnętrzny czynnik, taki jak przerwa w zasilaniu, nie przeciąży systemu.
Typowe błędy w konserwacji RAID, których należy unikać
Nawet doświadczone zespoły IT mogą przeoczyć najlepsze praktyki dotyczące RAID. Ponadto macierze RAID często działają nadal po jednej lub kilku awariach sprzętowych, ukrywając prawdziwy stan systemu. Pojedynczy uszkodzony dysk może nie wyłączyć systemu od razu, ale zwiększa ryzyko kaskadowej awarii dysków w całej macierzy.
Oto kilka typowych błędów, które często prowadzą do problemów:
Jeśli ulegnie awarii, zadzwoń do ekspertów
Nawet przy starannym planowaniu awarie się zdarzają. Gdy do nich dojdzie, kluczowe jest skontaktowanie się z doświadczonymi specjalistami, zanim podejmiesz jakiekolwiek działania. Bez względu na to, jak solidny jest Twój plan odtwarzania awaryjnego, profesjonalne wsparcie może przesądzić o tym, czy skończy się na tymczasowej przerwie, czy na trwałej utracie danych.
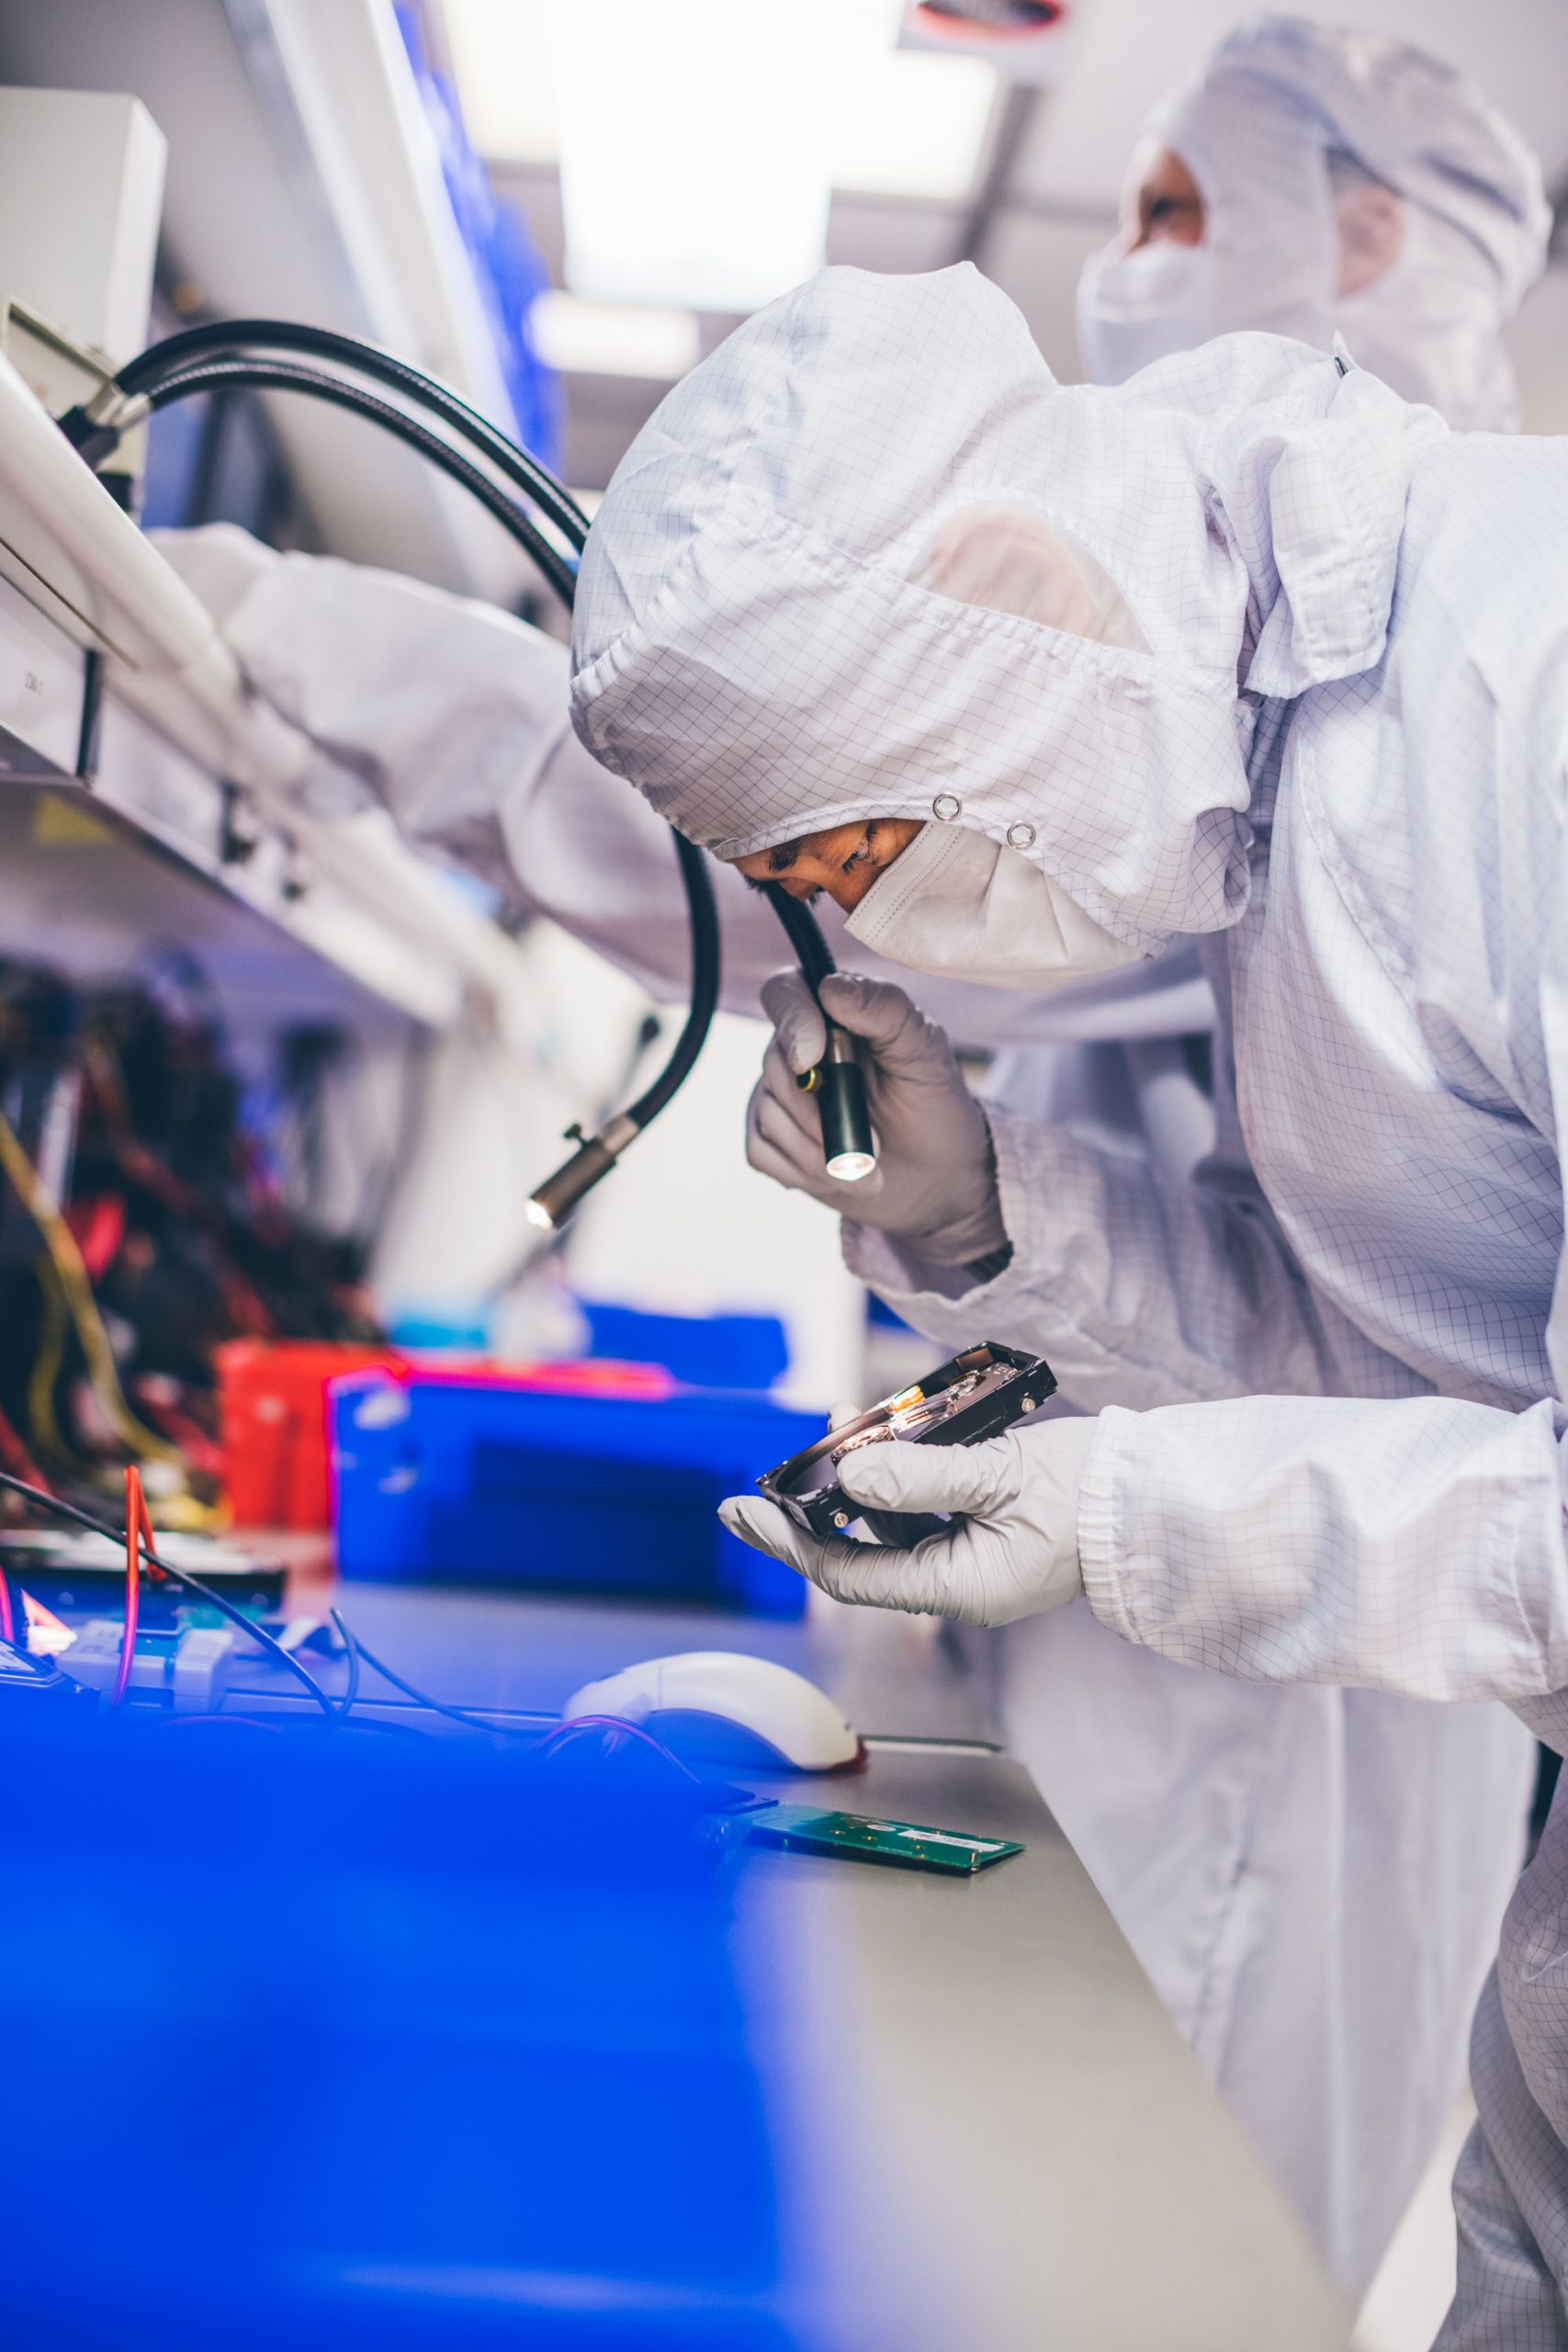
DriveSavers od dziesięcioleci jest zaufaną marką w profesjonalnych usługach odzyskiwania danych. Specjalizujemy się w usługach odzyskiwania danych RAID, obsługując wszystko, od prostych macierzy lustrzanych RAID 1 po RAID 50 na skalę przedsiębiorstwa i dalej. Odzyskiwaliśmy dane z serwerów uszkodzonych przez ogień, dysków zalanych wodą i całkowicie zniszczonych macierzy. Nasi inżynierowie pracują w certyfikowanych pomieszczeniach czystych, używając autorskich narzędzi, aby bezpiecznie odzyskać Twoje dane — nawet gdy inni dostawcy twierdzą, że się nie da.
Na koniec: czyste systemy, spokojne sumienie
Wiosna to czas odnowy – a Twoja macierz RAID zasługuje na ten sam świeży start. Pomijanie konserwacji RAID znacznie zwiększa ryzyko utraty danych, na co żadna firma nie może sobie pozwolić. Wykorzystaj tę okazję, aby wrócić do swojej listy kontrolnej konserwacji serwerów, zweryfikować systemy kopii zapasowych i ocenić stan swojego RAID.
Systemy RAID mogą być zbudowane z myślą o odporności, ale nie są niezniszczalne. Regularna konserwacja RAID to jedna z najmądrzejszych inwestycji, jakie możesz poczynić, aby chronić swoje dane – i swoją firmę – przed awariami, którym można zapobiec.
A jeśli katastrofa jednak nastąpi? DriveSavers zawsze jest gotowy pomóc w odzyskaniu tego, co najważniejsze. Skontaktuj się z nami, aby skorzystać z profesjonalnych rozwiązań do odzyskiwania danych i szybko oraz bezpiecznie odzyskać swoje pliki.

 English (United States)
 English (Australia)
 French (France)
 English (UK)
 French (Canada)
 English (Canada)
 Spanish (Mexico)
 German
 Dutch
 Italian
 Finnish
 Polish
 Norwegian
 Swedish
 Danish
 Spanish (Spain)
 Chinese
 Japanese
 German (Austria)