

Forårsklar RAID-vedligeholdelse: forebyg RAID-fejl med en tjekliste til servervedligeholdelse

Når årstiderne skifter, er det et ideelt tidspunkt at forny ikke blot dine omgivelser, men også din it-infrastruktur. Forårsrengøring er ikke begrænset til fysiske rum – den er lige så vigtig for dine digitale systemer. Regelmæssig RAID-vedligeholdelse kan hjælpe med at forebygge uventet nedetid, reducere omkostningerne på lang sigt og beskytte din organisation mod ødelæggende RAID-fejl.
Når dit RAID-array fungerer, som det skal, er det let at glemme, at det overhovedet findes. Men som ethvert forretningskritisk system har det brug for regelmæssig opmærksomhed. At anvende en struktureret tjekliste til servervedligeholdelse i dette forår er et smart, proaktivt skridt for at undgå kostbare afbrydelser.
RAID-vedligeholdelsens rolle i at forebygge katastrofer
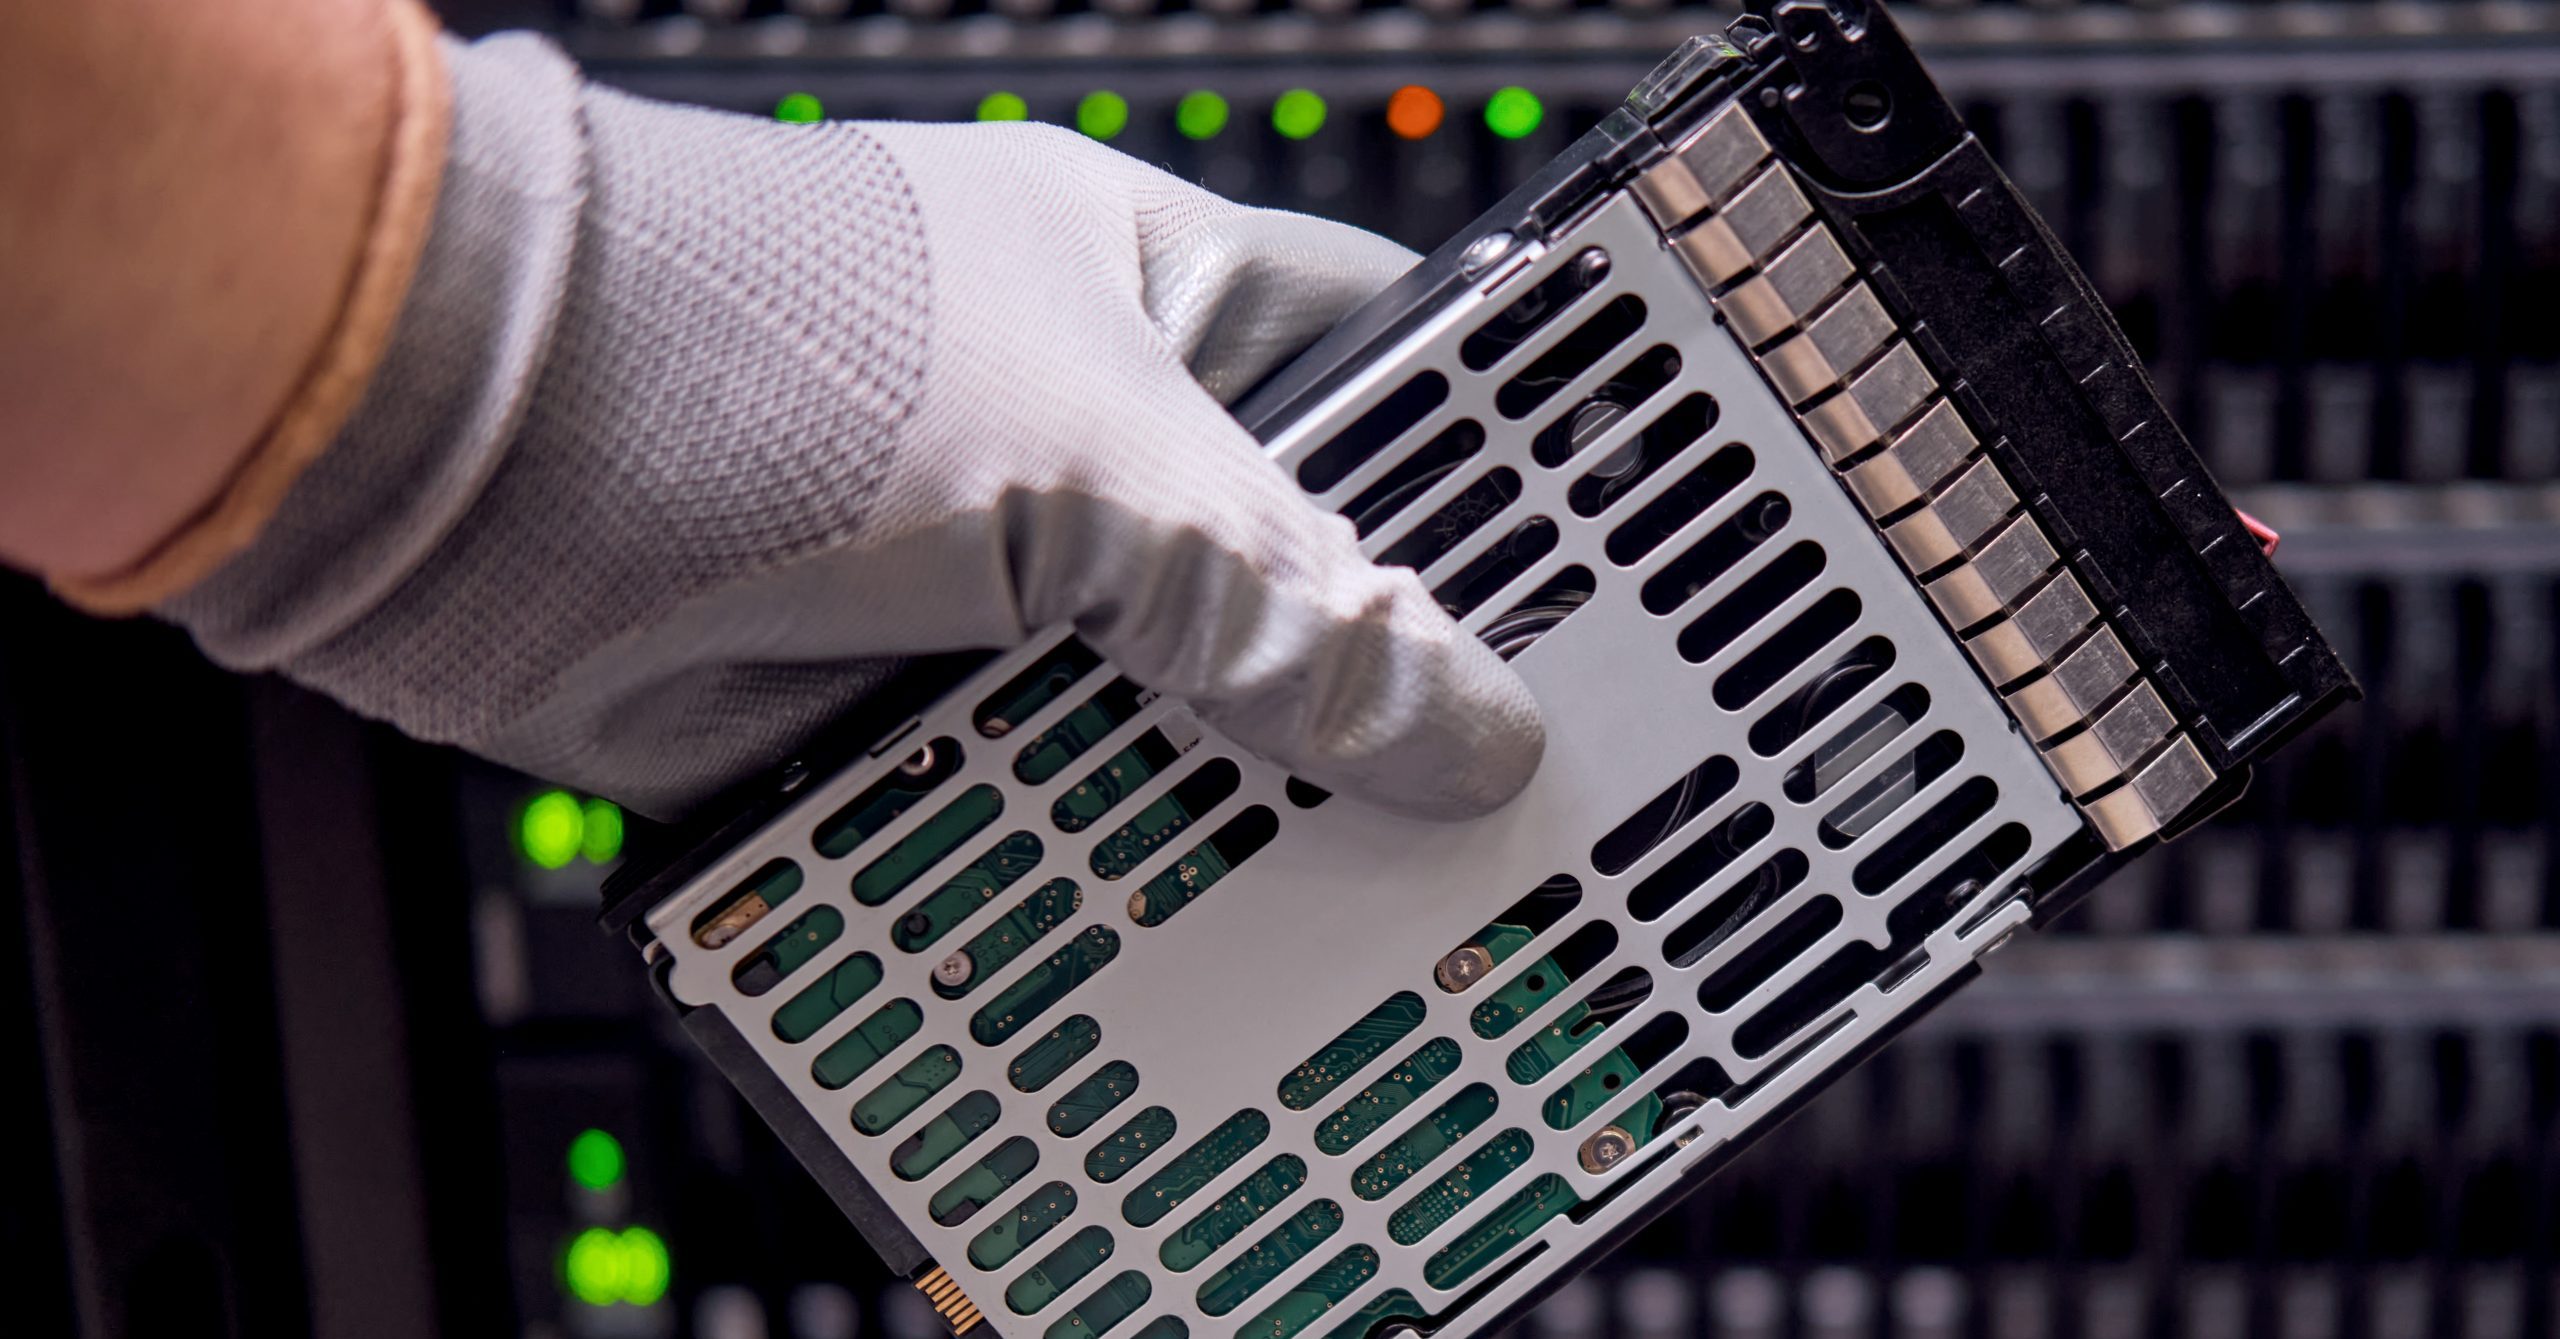
RAID-systemer (Redundant Array of Independent Disks, altså redundant samling af uafhængige diske) bruges i udstrakt grad på grund af deres hastighed og redundans. Men de er ikke immune over for fejl. Uden løbende RAID-vedligeholdelse kan selv de mest robuste konfigurationer forringes over tid, hvilket fører til fald i serverens ydeevne eller totale array-fejl.
RAID-arrays kan skjule drevfejl i en periode ved at køre i degraderet tilstand uden advarsel. Denne tavse forringelse bliver ofte først kritisk, når det er for sent: når et andet drev svigter, en controller fejler, eller systemet går helt ned. Uden indgriben kan disse problemer eskalere til en fuldstændig systemfejl, der forårsager omfattende nedetid. Forebyggende vedligeholdelse hjælper med at opdage og rette problemer, før de løber løbsk.
Kerneelementerne i en tjekliste til servervedligeholdelse
En gennemarbejdet tjekliste til serveradministration og -vedligeholdelse bør omfatte rutinemæssige kontroller af både hardware og software. Følgende opgaver er afgørende for at beskytte dit RAID-system:
Overvåg RAID-drevenes tilstand
Brug diagnoseværktøjer til at vurdere drevenes ydeevne på tværs af hele arrayet. Hold øje med tidlige tegn på fejl, såsom forsinkelser i genopbygningen eller forringelse af drevene.
Udfør regelmæssige backuptests
Antag aldrig, at backups fungerer. Udfør rutinemæssige gendannelsestests for at bekræfte, at gemte data faktisk kan gendannes, når der er brug for dem.
Opdater firmware og controllere
Hold RAID-controllerens firmware og drevenes software opdateret. Gammel firmware kan forårsage kompatibilitetsproblemer eller lade kritiske fejl forblive uløste.
Oprethold et ideelt servermiljø
Sørg for, at serverrum opfylder miljøstandarderne. Overophedning, støvophobning eller dårlig luftgennemstrømning kan med tiden mindske hardwarens pålidelighed.
Gennemgå logfiler og dokumentation
Dokumenter alle RAID-ændringer, drevudskiftninger og fejllogfiler. Nøjagtige optegnelser kan i høj grad forbedre fejlfinding og fremtidige genoprettelsesindsatser.
| Vedligeholdelsesopgave | Hvad der skal kontrolleres | Foreslået hyppighed* |
|---|---|---|
| RAID-arrayets tilstand | Led efter degraderede drev, fejlede arrays og genopbygningsproblemer | Dagligt / Ugentligt |
| Firmware- og softwareopdateringer | RAID-controller, drevenes firmware, administrationsværktøjer | Efter behov |
| Verifikation af backups | Test gendannelsespunkter, kontrollér logfiler for backupjob | Ugentligt / Månedligt |
| Miljøforhold | Temperatur, støv, luftgennemstrømning, strømforsyningens stabilitet | Månedligt |
| Gennemgang af logfiler og dokumentation | Drevfejl, genopbygningshistorik, konfigurationsændringer | Dagligt / Ugentligt |
*De viste hyppigheder er generelle anbefalinger. Hvert miljø er unikt – tilpas denne tjekliste efter dit datavolumen, dine systemers kritikalitet og din risikoprofil.
Et eksempel fra den virkelige verden på RAID-fejl
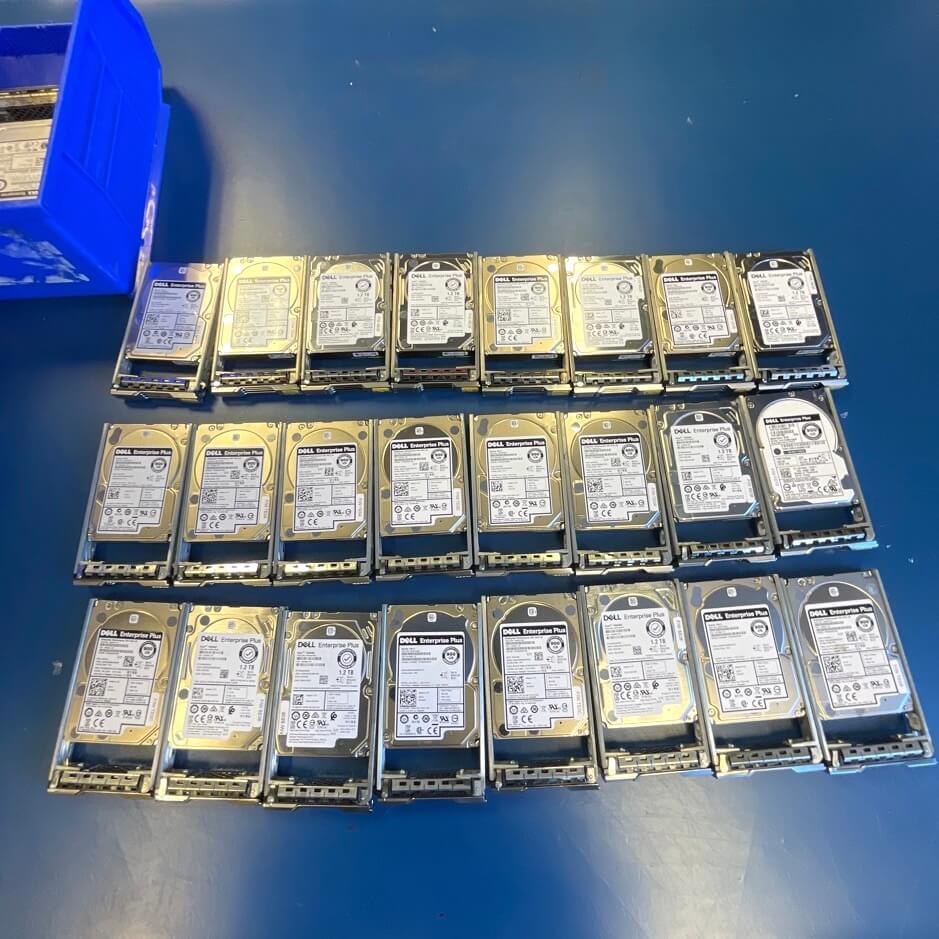
Strømsvingninger eller strømafbrud kan føre til datakorruption, drevforringelse eller endda et komplet servernedbrud.
Tag tilfældet med en tøjbutik, der oplevede flere harddiskfejl efter et strømafbrud. Deres Dell EqualLogic-system, der bestod af 44 drev i en kompleks RAID 50-konfiguration, led katastrofalt datatab på grund af, at flere drev svigtede samtidig.
DriveSavers blev kaldt ind for at genoprette dataene. Ingeniørerne udviklede skræddersyede værktøjer til at fortolke og rekonstruere systemets unikke struktur og formåede at genoprette størstedelen af butikkens kritiske data.
Selv om denne sag fik et positivt udfald, er den en tydelig påmindelse: RAID-fejl kan ramme hurtigt, især når systemer er sårbare. I dette tilfælde kunne regelmæssig RAID-vedligeholdelse have reduceret risikoen betydeligt.
Hvordan vedligeholdelse kunne have gjort en forskel
Lad os gennemgå, hvordan udfaldet kunne have set ud med en proaktiv vedligeholdelsesstrategi:
Kort sagt er RAID-fejl sjældent en enkeltpunktsfejl. Det er typisk en kæde af små problemer, der går ubemærket hen, indtil en ekstern udløser, som et strømafbrud, presser systemet ud over kanten.
Almindelige fejl ved RAID-vedligeholdelse, du bør undgå
Selv erfarne it-teams kan overse bedste praksis for RAID. Derudover fortsætter RAID-arrays ofte med at køre efter en eller flere hardwarefejl og skjuler dermed systemets reelle tilstand. Et enkelt drev, der svigter, sætter måske ikke systemet ud af spillet med det samme, men det øger risikoen for en kaskade af drevfejl på tværs af hele arrayet.
Her er nogle almindelige fejltrin, som ofte fører til problemer:
Hvis det svigter, så ring til eksperterne
Selv med omhyggelig planlægning opstår der fejl. Når det sker, er det afgørende at kontakte erfarne fagfolk, før du foretager dig noget. Uanset hvor solid din katastrofeberedskabsplan er, kan professionel støtte gøre forskellen mellem midlertidigt driftsstop og permanent tab.
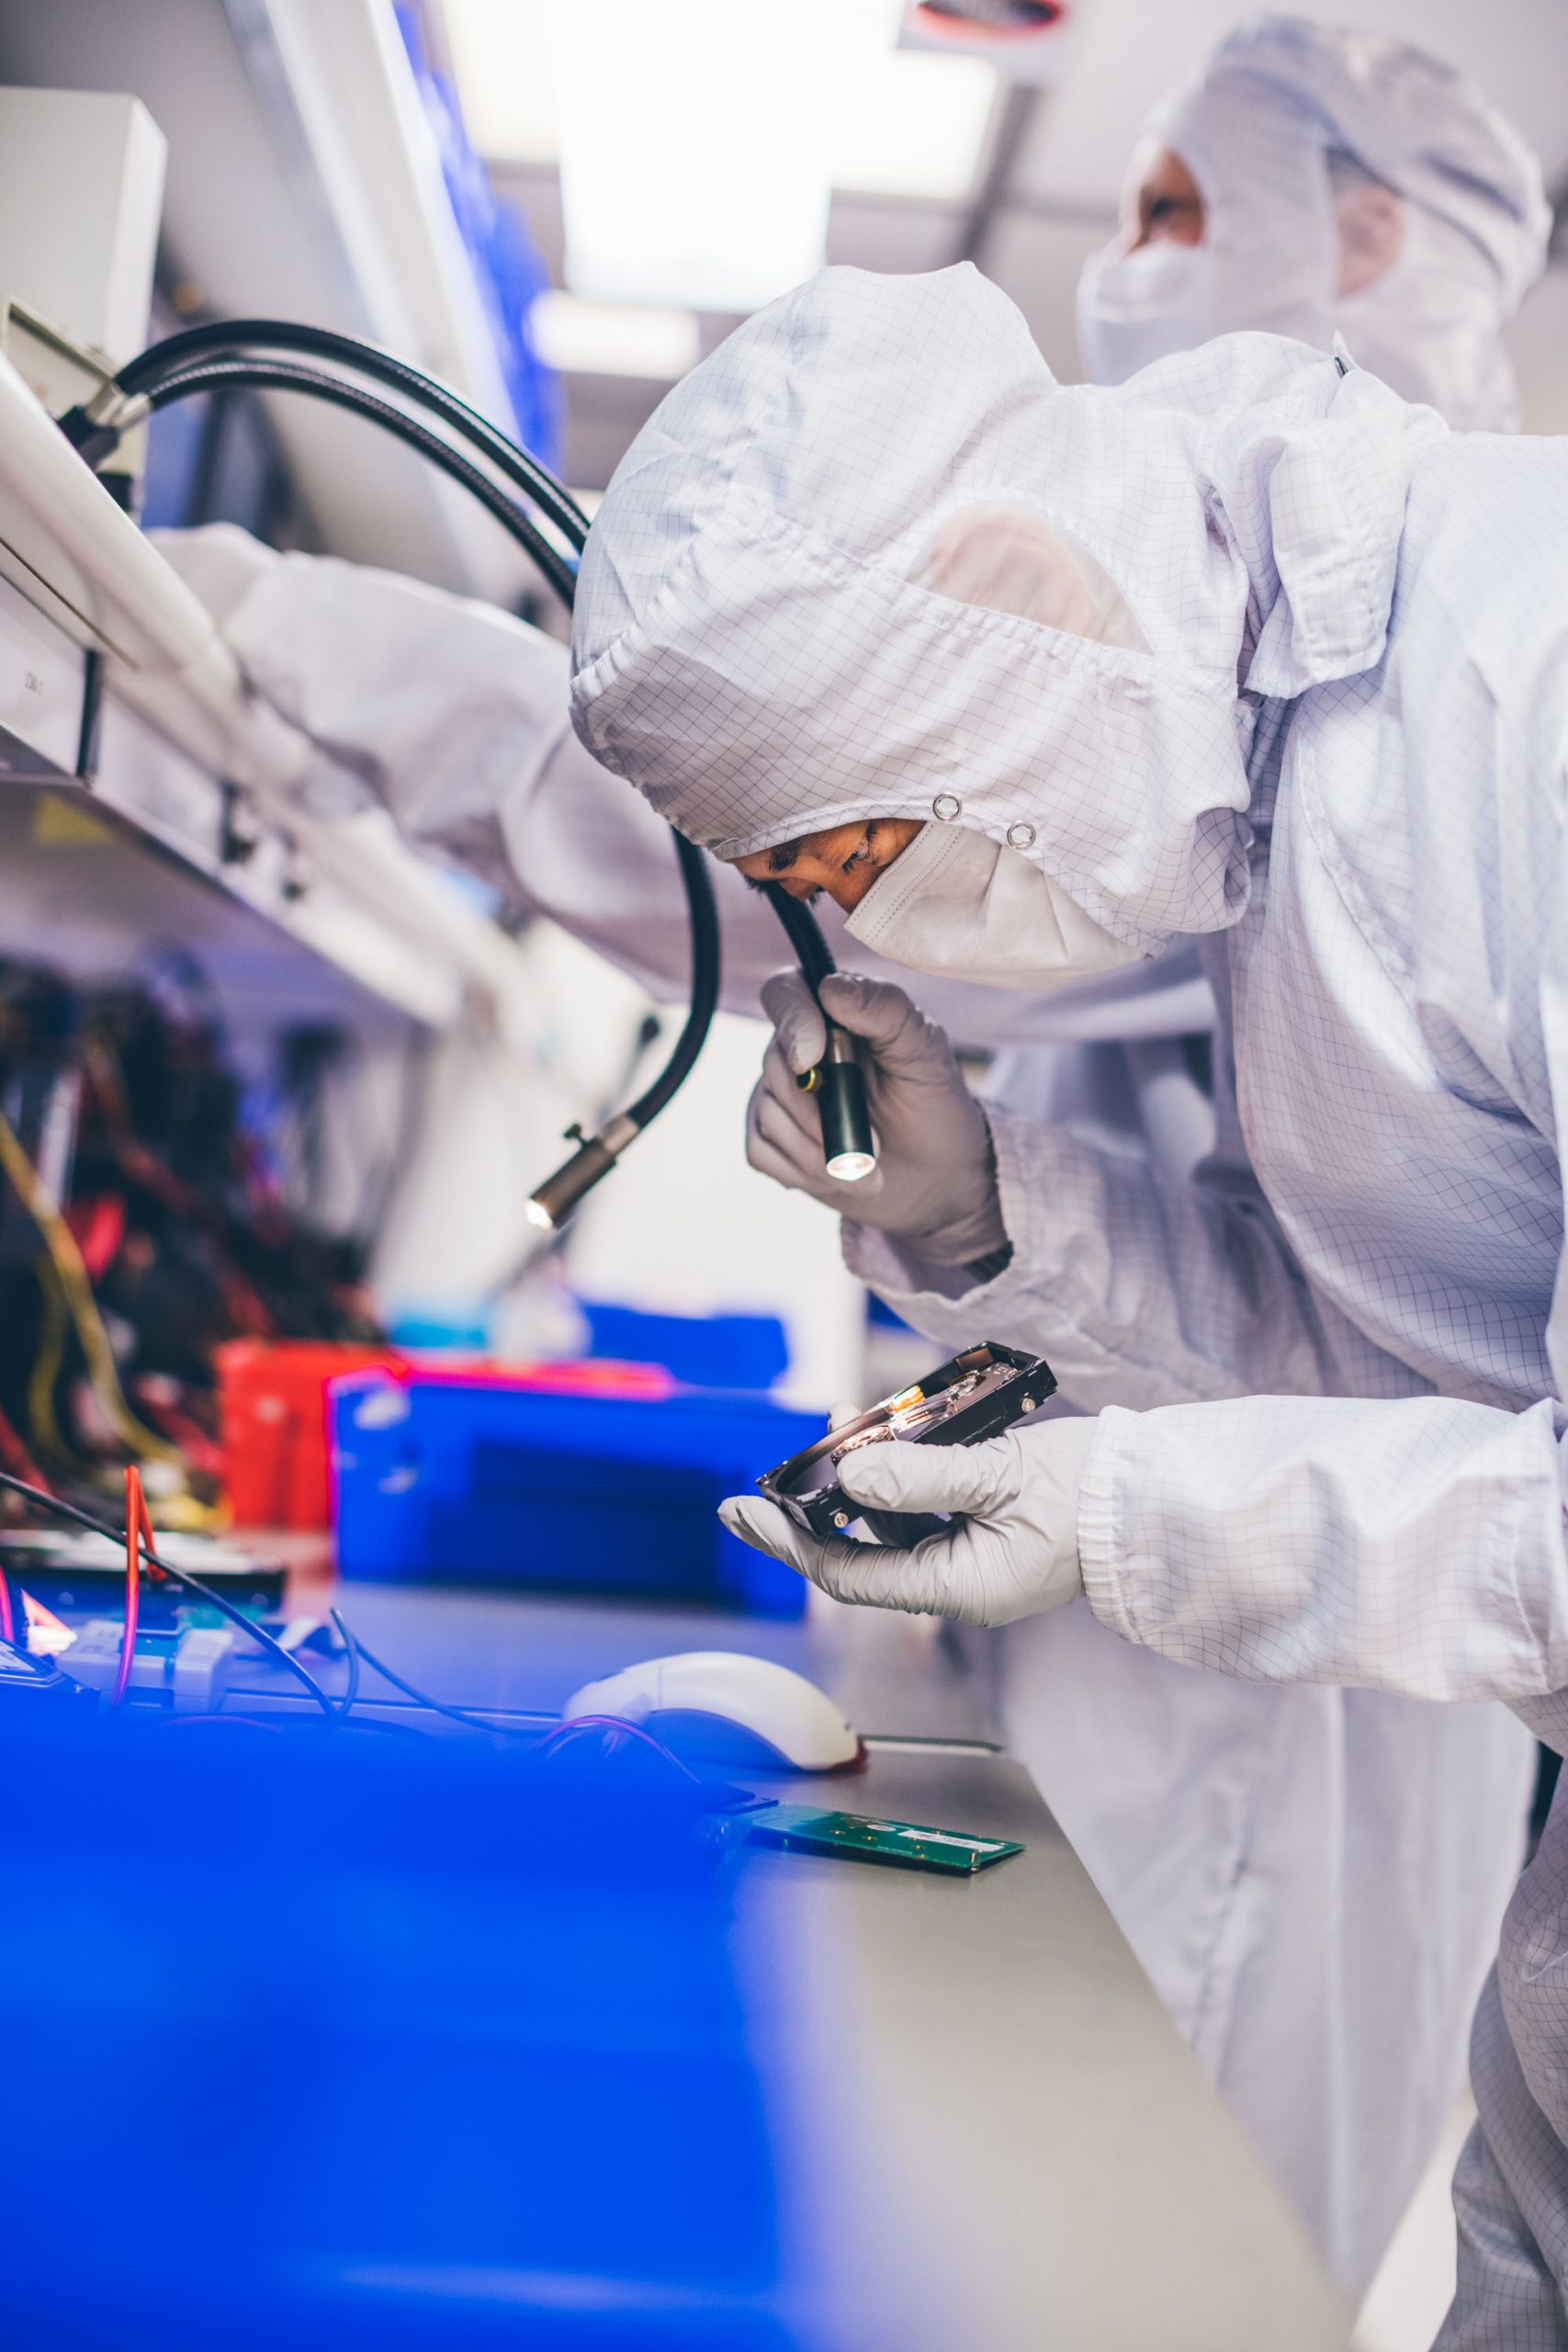
DriveSavers har i årtier været et pålideligt navn inden for professionelle datagenoprettelsestjenester. Vi er specialiseret i RAID-datagenoprettelsestjenester og håndterer alt fra simple RAID 1-spejlarrays til RAID 50 i virksomhedsskala og mere til. Vi har genoprettet data fra brandskadede servere, vanddrukne drev og totalt kollapsede arrays. Vores ingeniører arbejder i certificerede renrum med proprietære værktøjer for sikkert at genoprette dine data – selv når andre leverandører siger, at det ikke kan lade sig gøre.
Afsluttende tanker: ryddelige systemer, ren samvittighed
Foråret er en tid til fornyelse – og dit RAID-array fortjener den samme friske start. At springe RAID-vedligeholdelse over øger risikoen for datatab betydeligt, noget ingen virksomhed har råd til. Benyt lejligheden til at tage din tjekliste til servervedligeholdelse op igen, validere dine backupsystemer og vurdere dit RAID-systems tilstand.
RAID-systemer er måske bygget til at være robuste, men de er ikke uovervindelige. Regelmæssig RAID-vedligeholdelse er en af de smarteste investeringer, du kan foretage for at beskytte dine data, og din virksomhed, mod fejl, der kunne være undgået.
Og hvad hvis katastrofen alligevel rammer? DriveSavers er altid klar til at hjælpe dig med at genoprette det, der betyder mest. Kontakt os for professionelle datagenoprettelsesløsninger og få dine filer tilbage hurtigt og sikkert.

 English (United States)
 English (Australia)
 French (France)
 English (UK)
 French (Canada)
 English (Canada)
 Spanish (Mexico)
 German
 Dutch
 Italian
 Finnish
 Polish
 Norwegian
 Swedish
 Danish
 Spanish (Spain)
 Chinese
 Japanese
 German (Austria)