

Voorjaarsstart voor RAID-onderhoud: RAID-storingen voorkomen met een serveronderhoudschecklist

Nu de seizoenen wisselen, is het hhét moment om niet alleen uw omgeving, maar ook uw IT-infrastructuur nieuw leven in te blazen. De grote voorjaarsschoonmaak beperkt zich niet tot fysieke ruimtes: ze is even belangrijk voor uw digitale systemen. Regelmatig RAID-onderhoud kan helpen om onverwachte uitval te voorkomen, de kosten op lange termijn te verlagen en uw organisatie te beschermen tegen verwoestende RAID-storingen.
Wanneer uw RAID-array normaal functioneert, vergeet u makkelijk dat hij er überhaupt is. Maar net als elk bedrijfskritisch systeem heeft hij regelmatig aandacht nodig. Dit voorjaar een gestructureerde checklist voor serveronderhoud toepassen is een slimme, proactieve stap om kostbare verstoringen te voorkomen.
De rol van RAID-onderhoud bij het voorkomen van rampen
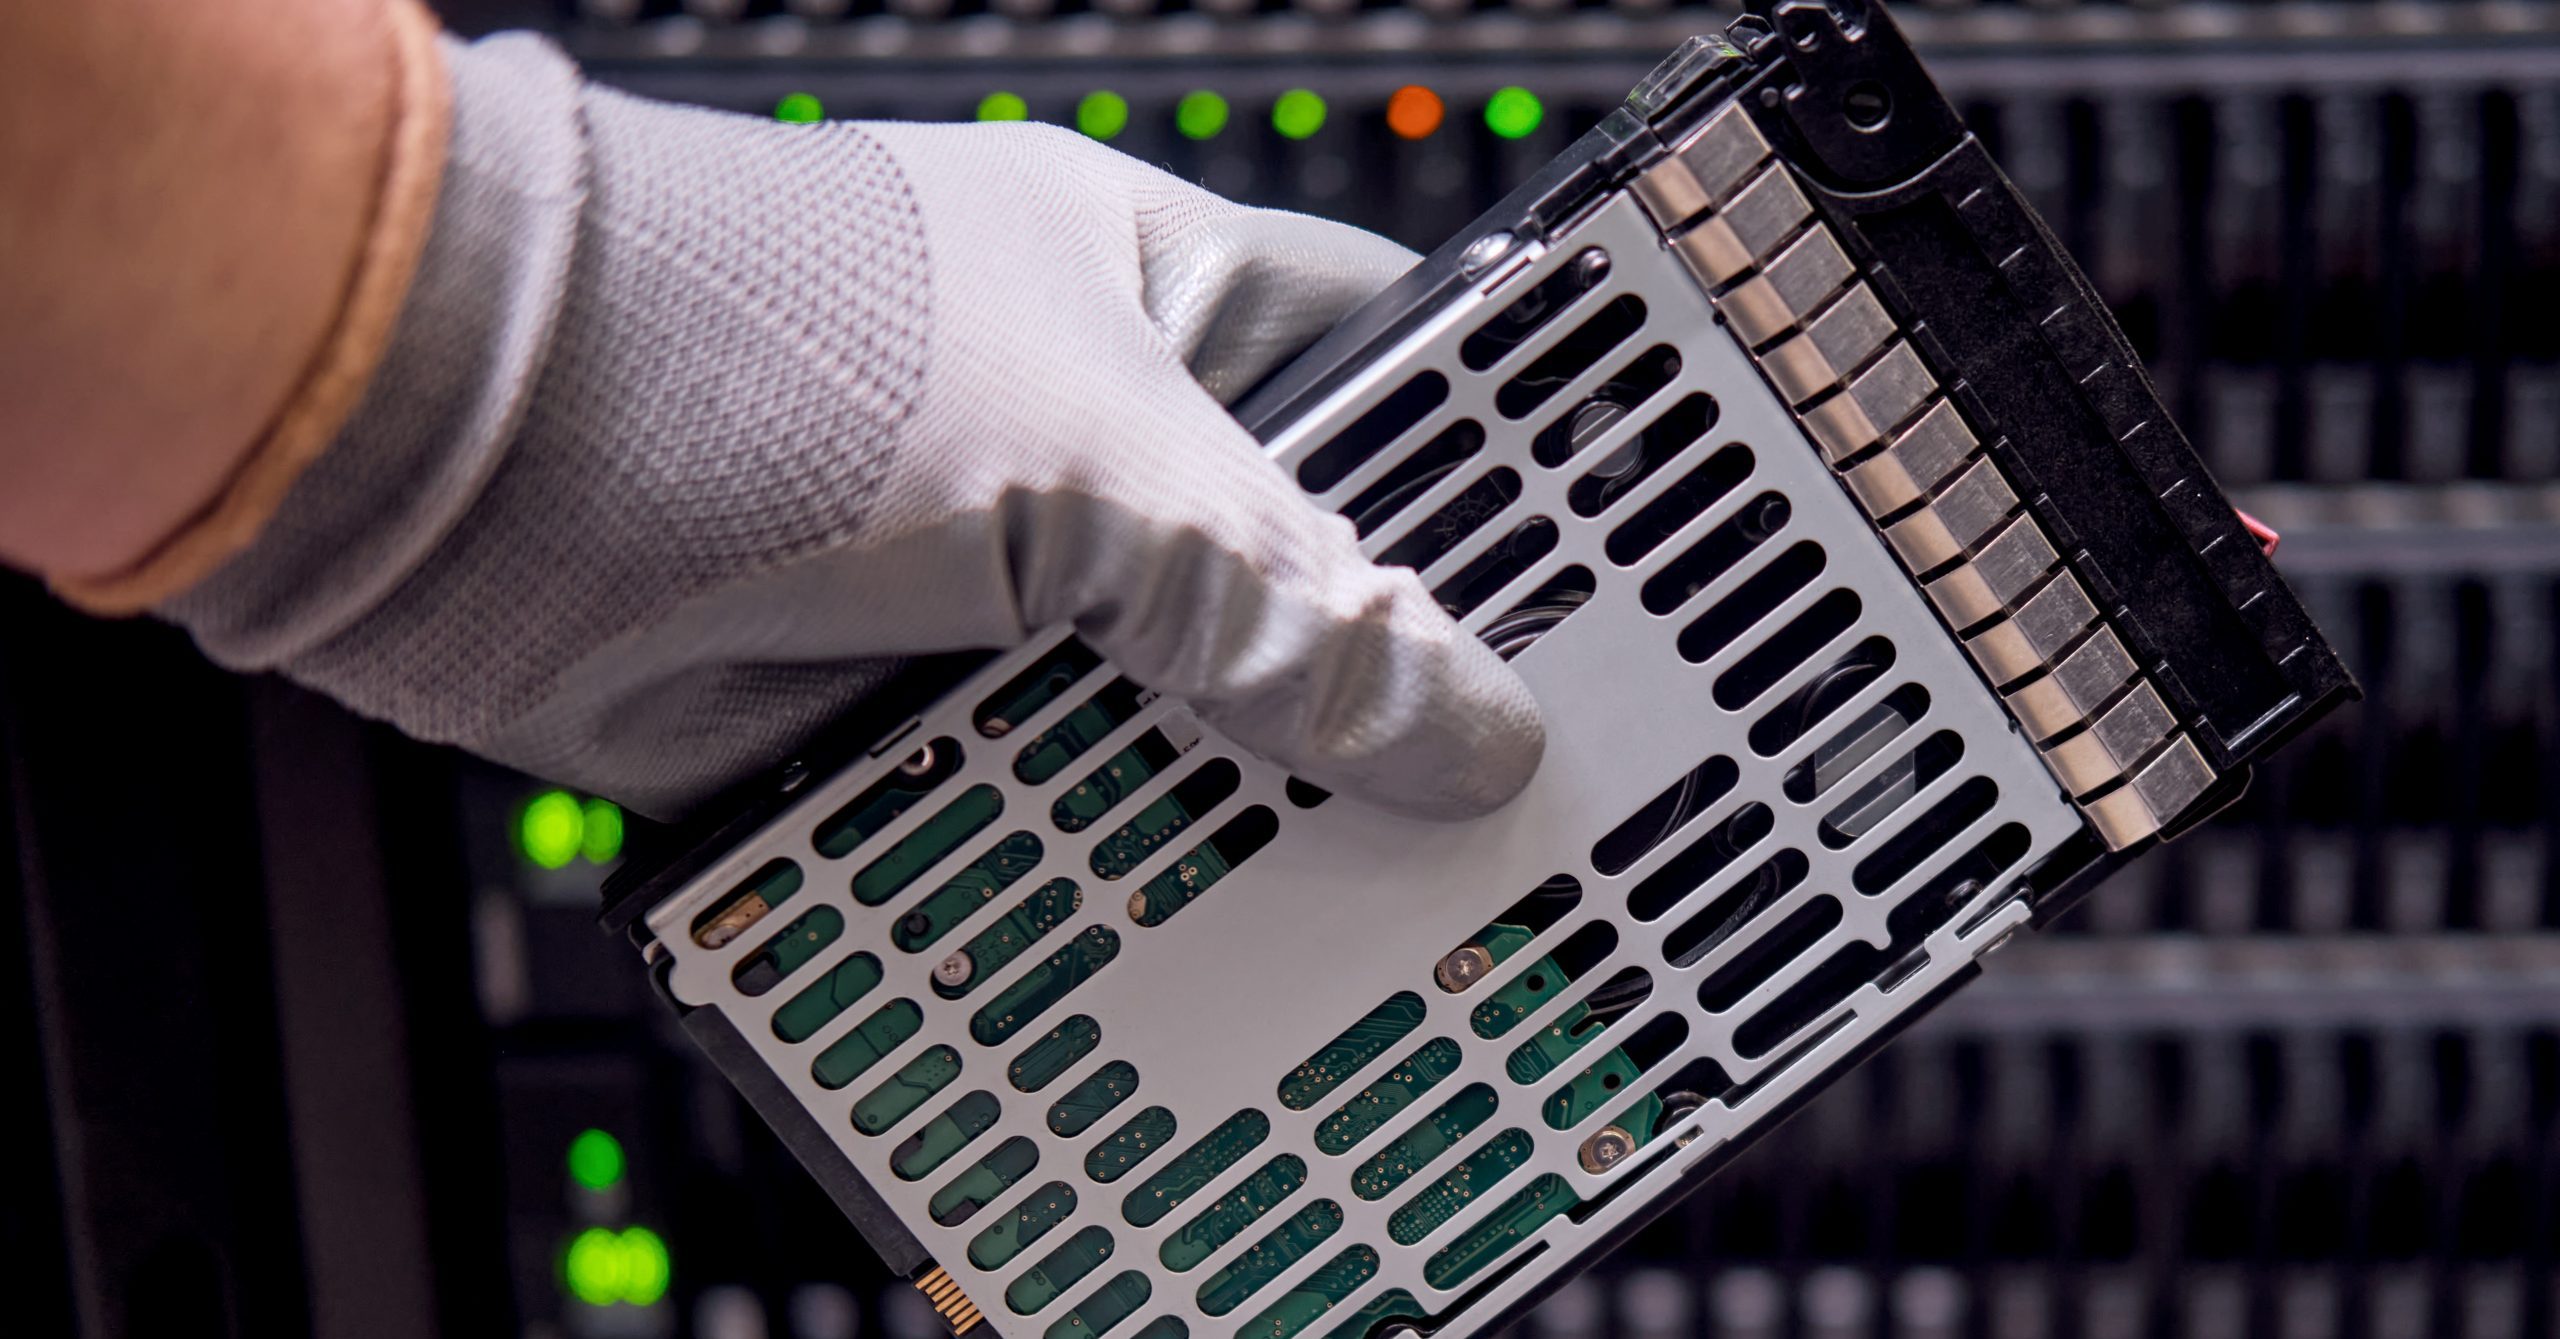
RAID-systemen (Redundant Array of Independent Disks, oftewel redundante reeks onafhankelijke schijven) worden veel gebruikt vanwege hun snelheid en redundantie. Maar ze zijn niet immuun voor storingen. Zonder doorlopend RAID-onderhoud kunnen zelfs de meest robuuste configuraties na verloop van tijd verslechteren, met prestatieverlies van de server of volledige array-uitval tot gevolg.
RAID-arrays kunnen schijfstoringen een tijdlang maskeren door zonder waarschuwing in gedegradeerde modus te blijven draaien. Die sluipende achteruitgang wordt vaak pas kritiek als het te laat is: wanneer een tweede schijf uitvalt, een controller defect raakt of het systeem helemaal crasht. Zonder ingrijpen kunnen deze problemen uitgroeien tot een volledige systeemstoring met wijdverbreide uitval tot gevolg. Preventief onderhoud helpt problemen op te sporen en te verhelpen voordat ze uit de hand lopen.
Kernelementen van een checklist voor serveronderhoud
Een goed doordachte checklist voor serverbeheer en -onderhoud moet routinecontroles van zowel hardware als software omvatten. De volgende taken zijn essentieel om uw RAID-systeem te beschermen:
Bewaak de gezondheid van RAID-schijven
Gebruik diagnostische tools om de prestaties van de schijven in de hele array te beoordelen. Let op vroege tekenen van uitval, zoals vertragingen bij het herbouwen of verslechtering van schijven.
Voer regelmatig back-uptests uit
Ga er nooit van uit dat back-ups werken. Voer regelmatig hersteltests uit om te controleren of opgeslagen gegevens daadwerkelijk kunnen worden hersteld wanneer dat nodig is.
Werk firmware en controllers bij
Houd de firmware van de RAID-controller en de software van de schijven up-to-date. Verouderde firmware kan compatibiliteitsproblemen veroorzaken of kritieke bugs onopgelost laten.
Zorg voor een ideale serveromgeving
Zorg ervoor dat serverruimtes aan de milieunormen voldoen. Oververhitting, stofophoping of slechte luchtstroom kunnen de betrouwbaarheid van hardware na verloop van tijd verminderen.
Controleer logboeken en documentatie
Documenteer alle RAID-wijzigingen, schijfvervangingen en foutlogboeken. Nauwkeurige gegevens kunnen het oplossen van problemen en toekomstige herstelwerkzaamheden aanzienlijk verbeteren.
| Onderhoudstaak | Wat te controleren | Aanbevolen frequentie* |
|---|---|---|
| Gezondheid van de RAID-array | Zoek naar gedegradeerde schijven, uitgevallen arrays en herbouwproblemen | Dagelijks / Wekelijks |
| Firmware- en software-updates | RAID-controller, schijffirmware, beheertools | Indien nodig |
| Back-upverificatie | Test herstelpunten, controleer de logboeken van back-uptaken | Wekelijks / Maandelijks |
| Omgevingscondities | Test herstelpunten, controleer de logboeken van back-uptaken | Maandelijks |
| Logboekcontrole en documentatie | Schijffouten, herbouwgeschiedenis, configuratiewijzigingen | Dagelijks / Wekelijks |
*De vermelde frequenties zijn algemene aanbevelingen. Elke omgeving is uniek: pas deze checklist aan op uw datavolume, de kritiekheid van uw systemen en uw risicoprofiel.
Een praktijkvoorbeeld van een RAID-storing
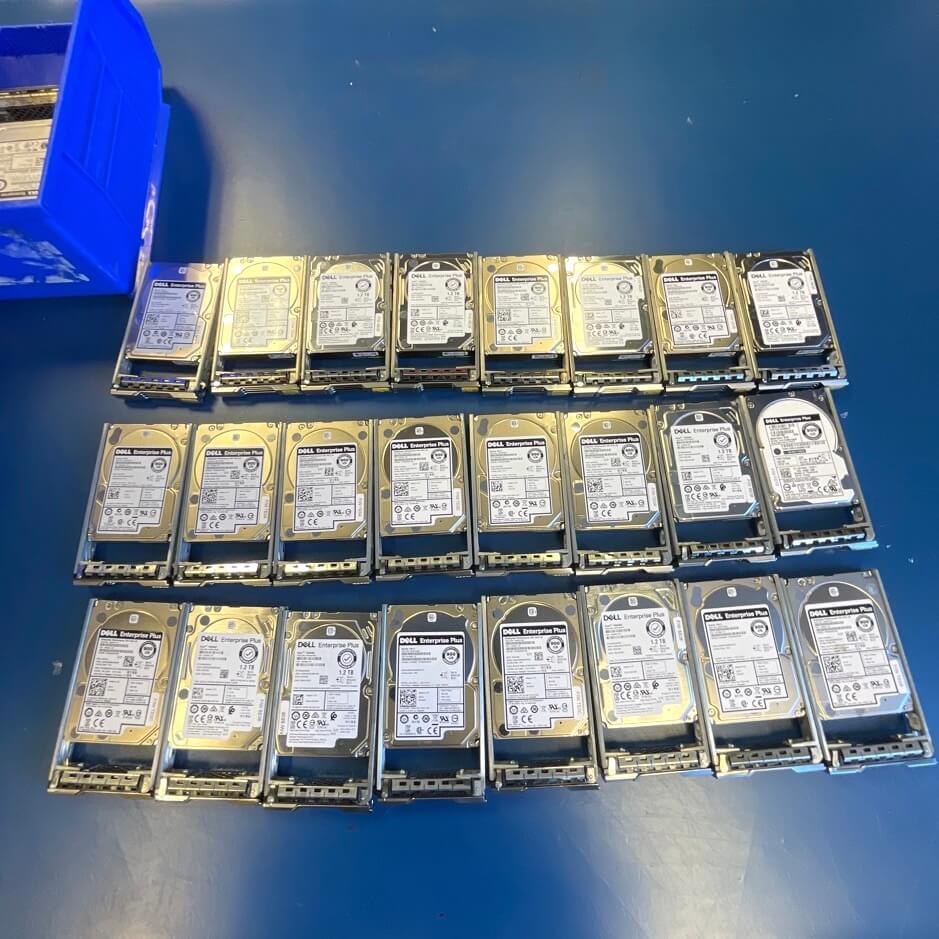
Stroomschommelingen of stroomstoringen kunnen leiden tot gegevenscorruptie, schijfdegradatie of zelfs een volledige servercrash.
Neem het geval van een kledingwinkel waarbij na een stroomstoring meerdere harde schijven uitvielen. Het Dell EqualLogic-systeem, bestaande uit 44 schijven in een complexe RAID 50-configuratie, kreeg te maken met catastrofaal gegevensverlies doordat meerdere schijven tegelijkertijd uitvielen.
DriveSavers werd ingeschakeld om de gegevens te herstellen. Ingenieurs ontwikkelden maatwerktools om de unieke structuur van het systeem te interpreteren en te reconstrueren, en slaagden erin het merendeel van de cruciale gegevens van de winkel terug te halen.
Maar hoewel deze zaak een goede afloop had, is het een duidelijke herinnering: een RAID-storing kan snel toeslaan, vooral wanneer systemen kwetsbaar zijn. In dit geval had regelmatig RAID-onderhoud het risico aanzienlijk kunnen verkleinen.
Hoe onderhoud het verschil had kunnen maken
Laten we eens bekijken hoe de uitkomst had kunnen veranderen met een proactieve onderhoudsstrategie:
Kortom: een RAID-storing is zelden een storing op één enkel punt. Het is doorgaans een keten van kleine problemen die onopgemerkt blijven totdat een externe trigger, zoals een stroomstoring, het systeem over de rand duwt.
Veelgemaakte fouten bij RAID-onderhoud die u moet vermijden
Zelfs ervaren IT-teams kunnen best practices voor RAID over het hoofd zien. Bovendien blijven RAID-arrays vaak werken na een of meer hardwarestoringen, waardoor de werkelijke toestand van het systeem verborgen blijft. Eén uitgevallen schijf legt het systeem niet per se direct plat, maar vergroot wel het risico op een kettingreactie van schijfuitval in de hele array.
Hier volgen enkele veelvoorkomende misstappen die vaak tot problemen leiden:
Als het misgaat, bel de experts
Zelfs met zorgvuldige planning gaat er weleens iets mis. Wanneer dat gebeurt, is het van cruciaal belang om ervaren professionals in te schakelen voordat u welke actie dan ook onderneemt. Hoe solide uw disaster recovery-plan ook is, professionele ondersteuning kan het verschil maken tussen tijdelijke verstoring en blijvend verlies.
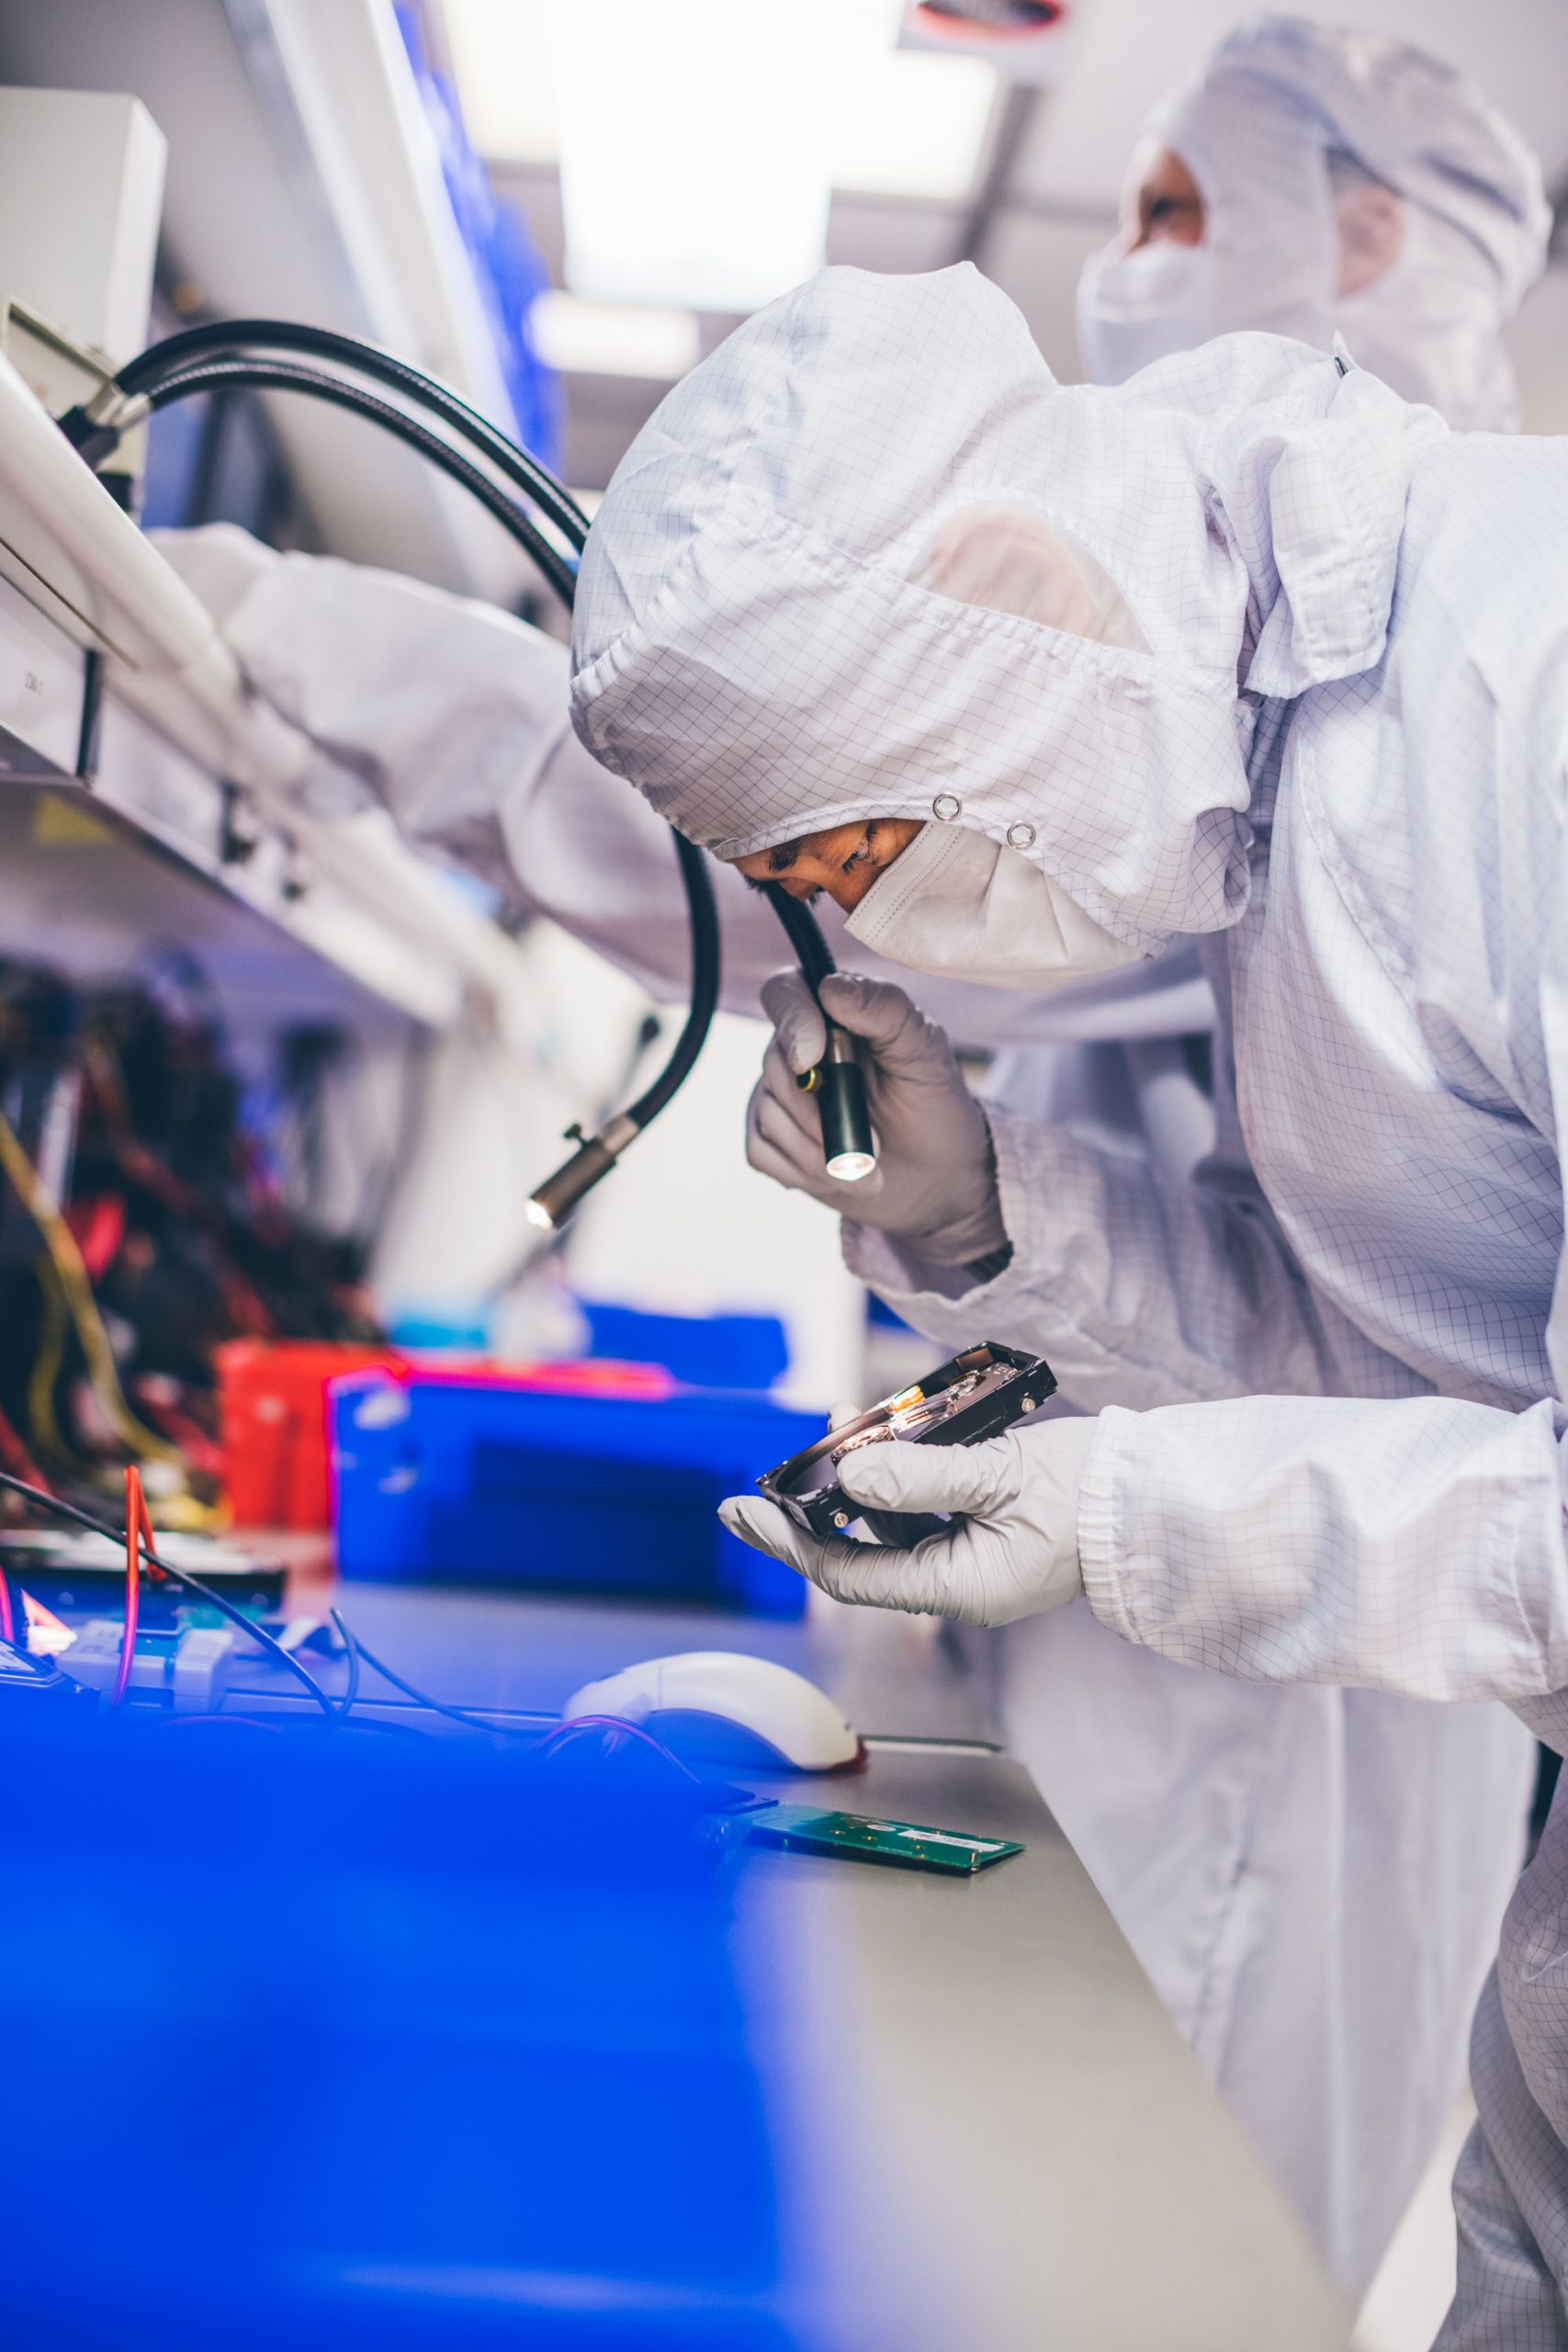
DriveSavers is al tientallen jaren een vertrouwde naam op het gebied van professionele dataherstelservices. Wij zijn gespecialiseerd in RAID-dataherstelservices en behandelen alles, van eenvoudige RAID 1-spiegelarrays tot RAID 50 op bedrijfsschaal en verder. We hebben gegevens hersteld van door brand beschadigde servers, in water gedrenkte schijven en volledig ingestorte arrays. Onze ingenieurs werken in gecertificeerde cleanrooms met eigen tools om uw gegevens veilig te herstellen, zelfs wanneer andere aanbieders zeggen dat het niet kan.
Slotgedachten: schone systemen, een gerust gevoel
De lente is een tijd van vernieuwing, en uw RAID-array verdient diezelfde frisse start. Het overslaan van RAID-onderhoud vergroot het risico op gegevensverlies aanzienlijk, iets wat geen enkel bedrijf zich kan veroorloven. Gebruik deze gelegenheid om uw checklist voor serveronderhoud weer ter hand te nemen, uw back-upsystemen te valideren en de gezondheid van uw RAID te beoordelen.
RAID-systemen zijn misschien gebouwd voor veerkracht, maar ze zijn niet onoverwinnelijk. Regelmatig RAID-onderhoud is een van de slimste investeringen die u kunt doen om uw gegevens, en uw bedrijf, te beschermen tegen vermijdbare storingen.
En als er toch een ramp gebeurt? DriveSavers staat altijd klaar om te helpen herstellen wat het belangrijkst is. Neem contact met ons op voor professionele dataherstelsoplossingen en krijg uw bestanden snel en veilig terug.

 English (United States)
 English (Australia)
 French (France)
 English (UK)
 French (Canada)
 English (Canada)
 Spanish (Mexico)
 German
 Dutch
 Italian
 Finnish
 Polish
 Norwegian
 Swedish
 Danish
 Spanish (Spain)
 Chinese
 Japanese
 German (Austria)