

È tempo di manutenzione RAID: prevenire i guasti RAID con una checklist di manutenzione dei server

Con il cambio di stagione, è il momento ideale per rinnovare non solo l'ambiente che ti circonda, ma anche la tua infrastruttura IT. Le pulizie di primavera non si limitano agli spazi fisici: sono altrettanto fondamentali per i tuoi sistemi digitali. Una manutenzione RAID regolare può aiutare a prevenire downtime imprevisti, ridurre i costi a lungo termine e proteggere la tua organizzazione da devastanti guasti RAID.
Quando il tuo array RAID funziona normalmente, è facile dimenticarsi persino che esista. Ma, come qualsiasi sistema mission-critical, ha bisogno di attenzione regolare. Applicare una checklist di manutenzione dei server strutturata questa primavera è un passo intelligente e proattivo per evitare interruzioni costose.
Il ruolo della manutenzione RAID nella prevenzione dei disastri
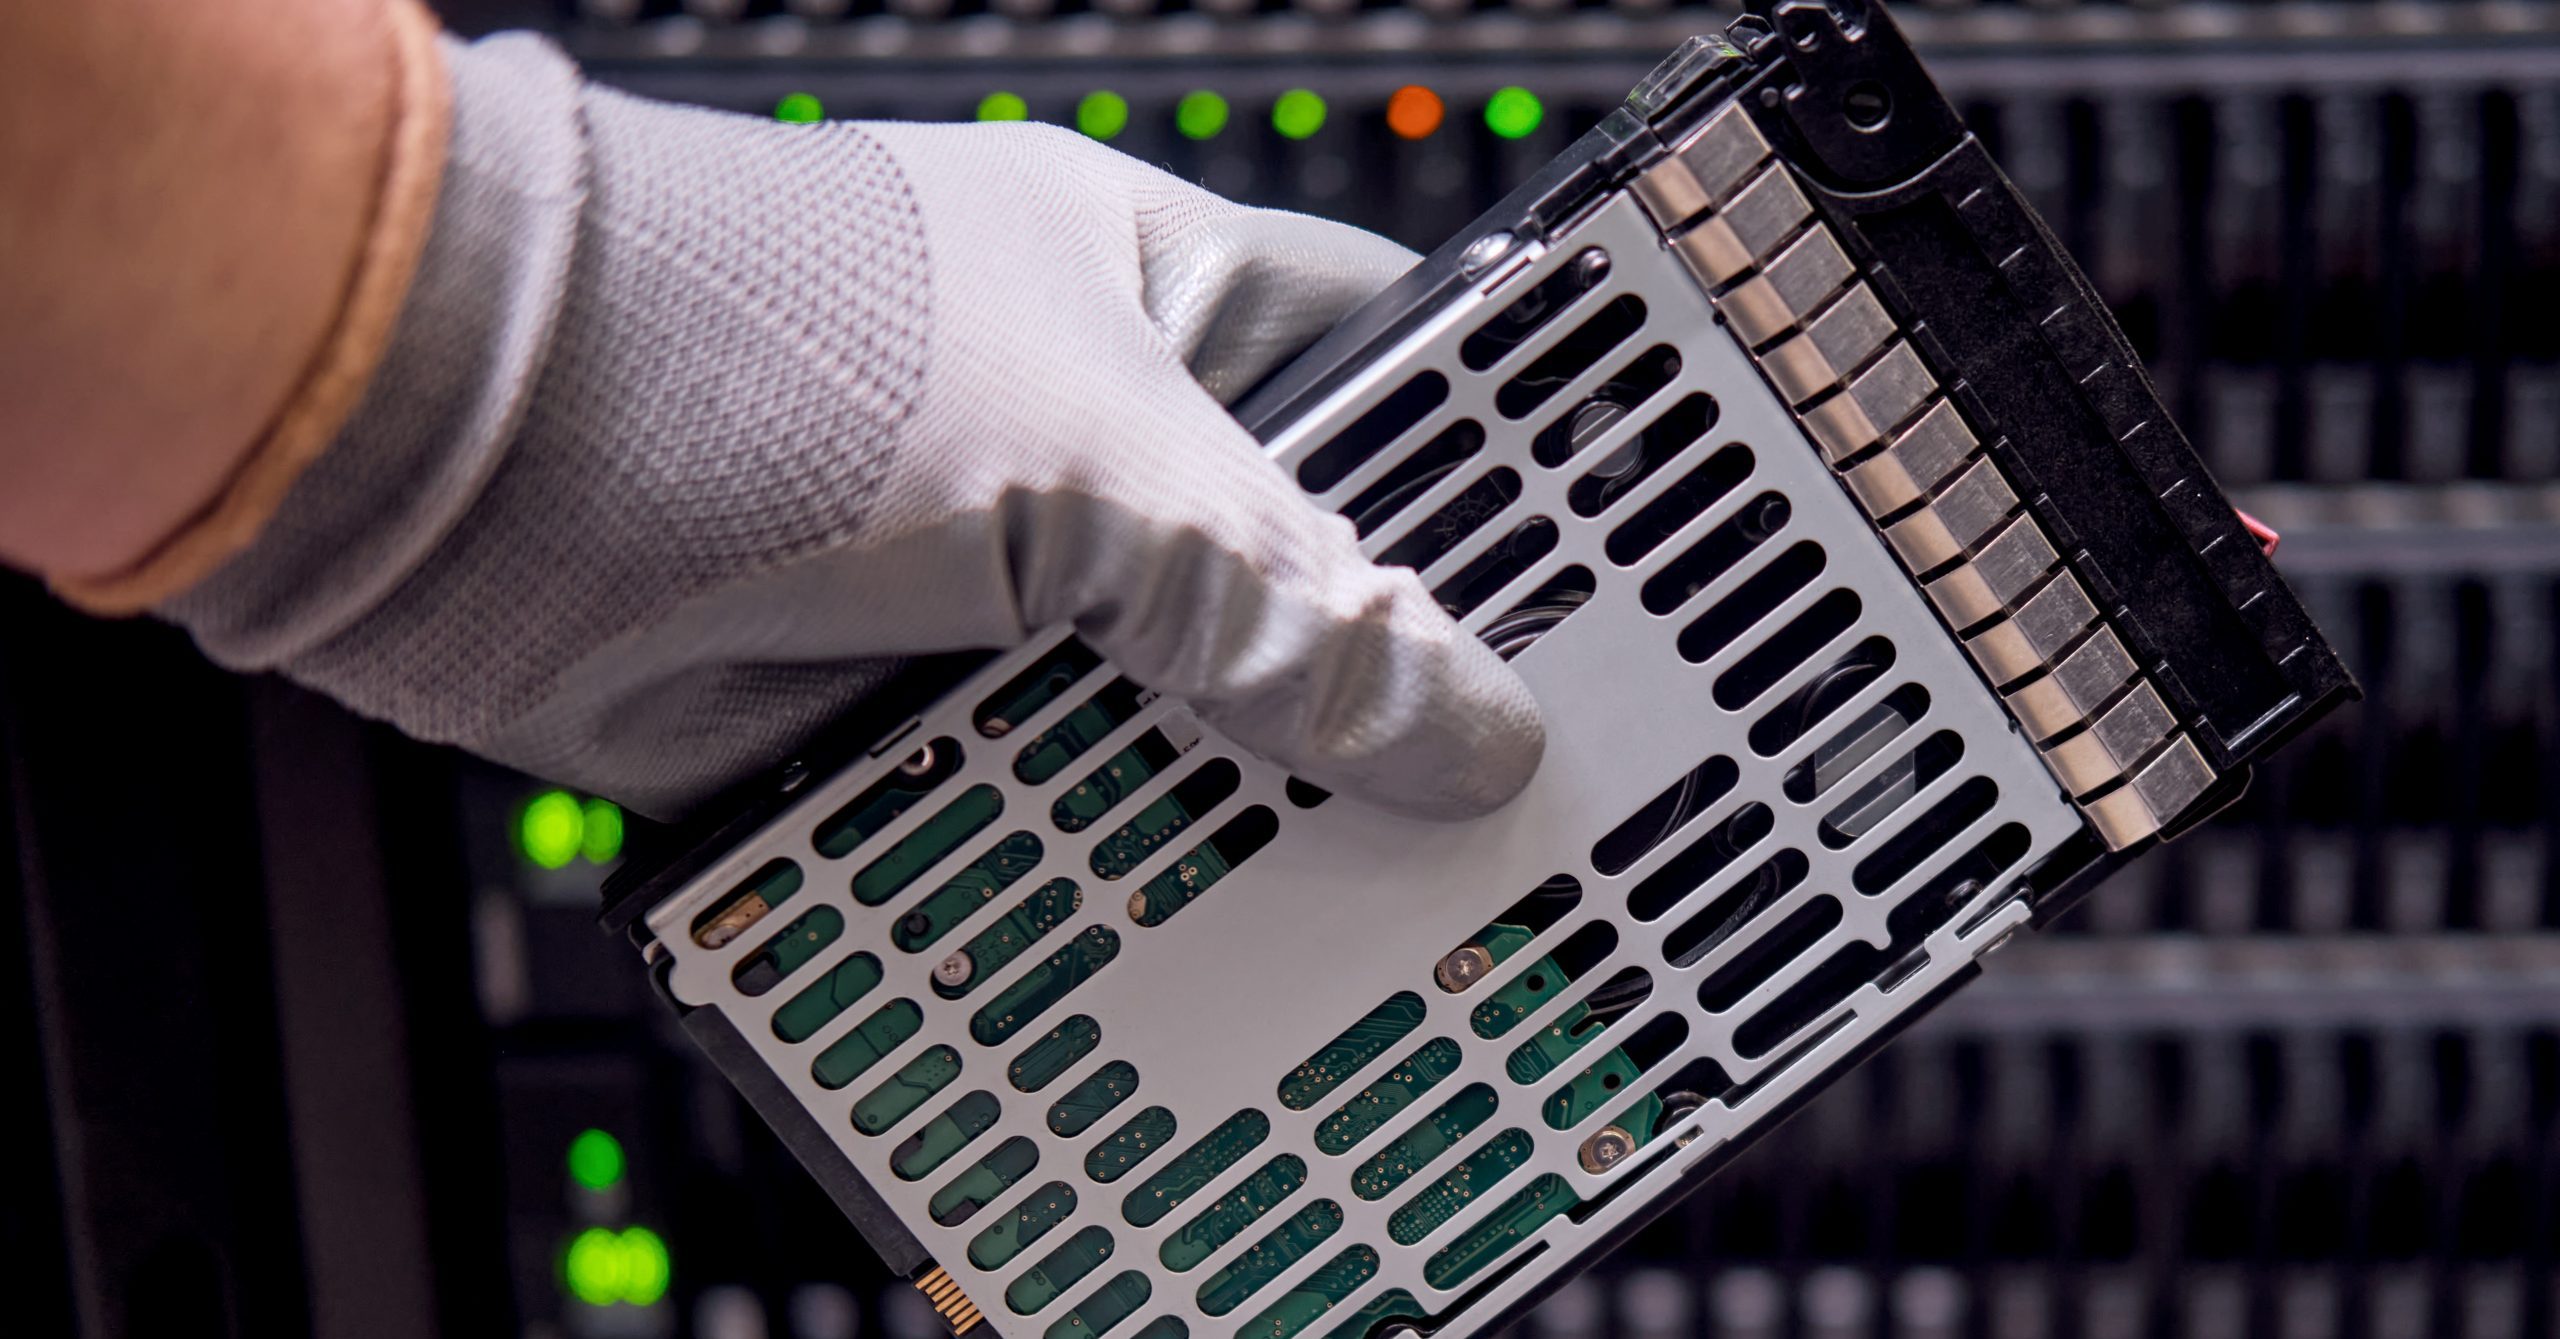
I sistemi RAID (Redundant Array of Independent Disks, ovvero matrice ridondante di dischi indipendenti) sono ampiamente utilizzati per la loro velocità e ridondanza. Ma non sono immuni ai guasti. Senza una manutenzione RAID costante, anche le configurazioni più robuste possono degradarsi nel tempo, causando cali di prestazioni del server o guasti completi dell'array.
Gli array RAID possono mascherare per un certo periodo i guasti ai dischi, funzionando in modalità degradata senza alcun avviso. Questo degrado silenzioso diventa spesso critico solo quando è ormai troppo tardi: quando si guasta un secondo disco, un controller non funziona correttamente o il sistema va in crash completamente. Senza intervento, questi problemi possono degenerare in un guasto di sistema su vasta scala, causando downtime diffuso. La manutenzione preventiva aiuta a rilevare e correggere i problemi prima che peggiorino.
Elementi fondamentali di una checklist di manutenzione dei server
Una checklist di gestione e manutenzione dei server completa dovrebbe includere controlli di routine sia sull'hardware sia sul software. Le seguenti attività sono essenziali per proteggere il tuo sistema RAID:
Monitora lo stato di salute dei dischi RAID
Utilizza strumenti diagnostici per valutare le prestazioni dei dischi in tutto l'array. Fai attenzione ai primi segnali di guasto, come i ritardi nella ricostruzione o il degrado dei dischi.
Esegui test di backup regolari
Non dare mai per scontato che i backup funzionino. Esegui test di ripristino periodici per verificare che i dati salvati siano effettivamente recuperabili quando servono.
Aggiorna firmware e controller
Mantieni aggiornati il firmware del controller RAID e il software dei dischi. Un firmware obsoleto può causare problemi di compatibilità o lasciare irrisolti bug critici.
<span style="color: #e31f26
Assicurati che le sale server rispettino gli standard ambientali. Surriscaldamento, accumulo di polvere o scarsa circolazione dell'aria possono ridurre nel tempo l'affidabilità dell'hardware.
Esamina i log e la documentazione
Documenta tutte le modifiche RAID, le sostituzioni dei dischi e i log degli errori. Registrazioni accurate possono migliorare notevolmente la risoluzione dei problemi e le future operazioni di recupero.
| Attività di manutenzione | Cosa controllare | Frequenza consigliata* |
|---|---|---|
| Stato di salute dell'array RAID | Cerca dischi degradati, array in errore e problemi di ricostruzione | Giornaliera / Settimanale |
| Aggiornamenti di firmware e software | Controller RAID, firmware dei dischi, strumenti di gestione | Se necessario |
| Verifica dei backup | Testa i punti di ripristino, controlla i log dei job di backup | Settimanale / Mensile |
| Condizioni ambientali | Temperatura, polvere, flusso d'aria, stabilità dell'alimentazione | Mensile |
| Revisione dei log e documentazione | Errori dei dischi, cronologia delle ricostruzioni, modifiche alla configurazione | Giornaliera / Settimanale |
*Le frequenze indicate sono raccomandazioni generali. Ogni ambiente è unico: adatta questa checklist al tuo volume di dati, alla criticità dei tuoi sistemi e al tuo profilo di rischio.
Un esempio reale di guasto RAID
Le fluttuazioni di tensione o le interruzioni di corrente possono causare corruzione dei dati, degrado dei dischi o persino un crash completo del server.
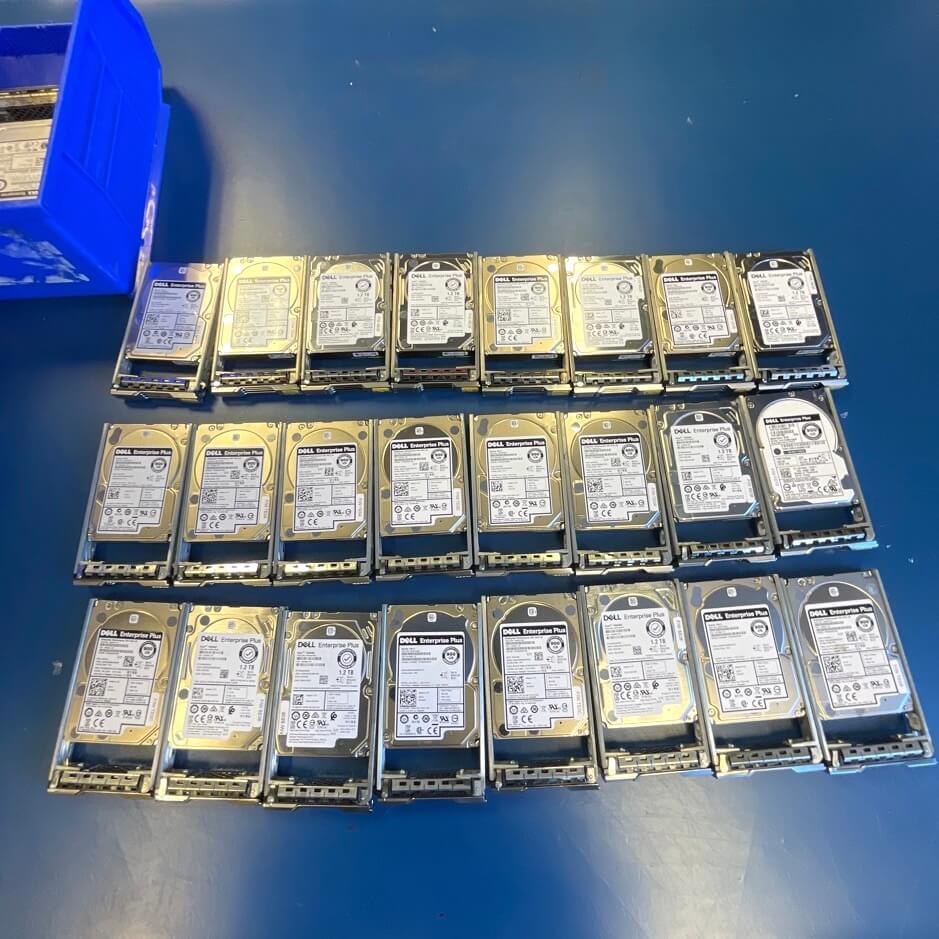
Prendiamo il caso di un negozio di abbigliamento che ha subito il guasto di più hard disk dopo un'interruzione di corrente. Il suo sistema Dell EqualLogic, composto da 44 dischi in una complessa configurazione RAID 50, ha subito una perdita di dati catastrofica a causa del guasto simultaneo di diversi dischi.
DriveSavers è stata chiamata per recuperare i dati. Gli ingegneri hanno sviluppato strumenti personalizzati per interpretare e ricostruire la struttura unica del sistema, riuscendo a recuperare la maggior parte dei dati critici del negozio.
Ma, pur avendo avuto un esito positivo, questo caso è un chiaro promemoria: un guasto RAID può colpire rapidamente, soprattutto quando i sistemi sono vulnerabili. In questo caso, una manutenzione RAID regolare avrebbe potuto ridurre significativamente il rischio.
Come la manutenzione avrebbe potuto fare la differenza
Vediamo come l'esito avrebbe potuto cambiare con una strategia di manutenzione proattiva:
In breve, il guasto RAID è raramente un guasto a punto singolo. In genere è una catena di piccoli problemi che passano inosservati finché un fattore scatenante esterno, come un'interruzione di corrente, spinge il sistema oltre il limite.
Errori comuni nella manutenzione RAID da evitare
Anche i team IT più esperti possono trascurare le best practice RAID. Inoltre, gli array RAID spesso continuano a funzionare dopo uno o più guasti hardware, nascondendo il reale stato del sistema. Un singolo disco guasto potrebbe non mettere subito fuori uso il sistema, ma aumenta il rischio di un guasto a cascata dei dischi in tutto l'array.
Ecco alcuni passi falsi comuni che spesso portano a problemi:
Se si guasta, chiama gli esperti
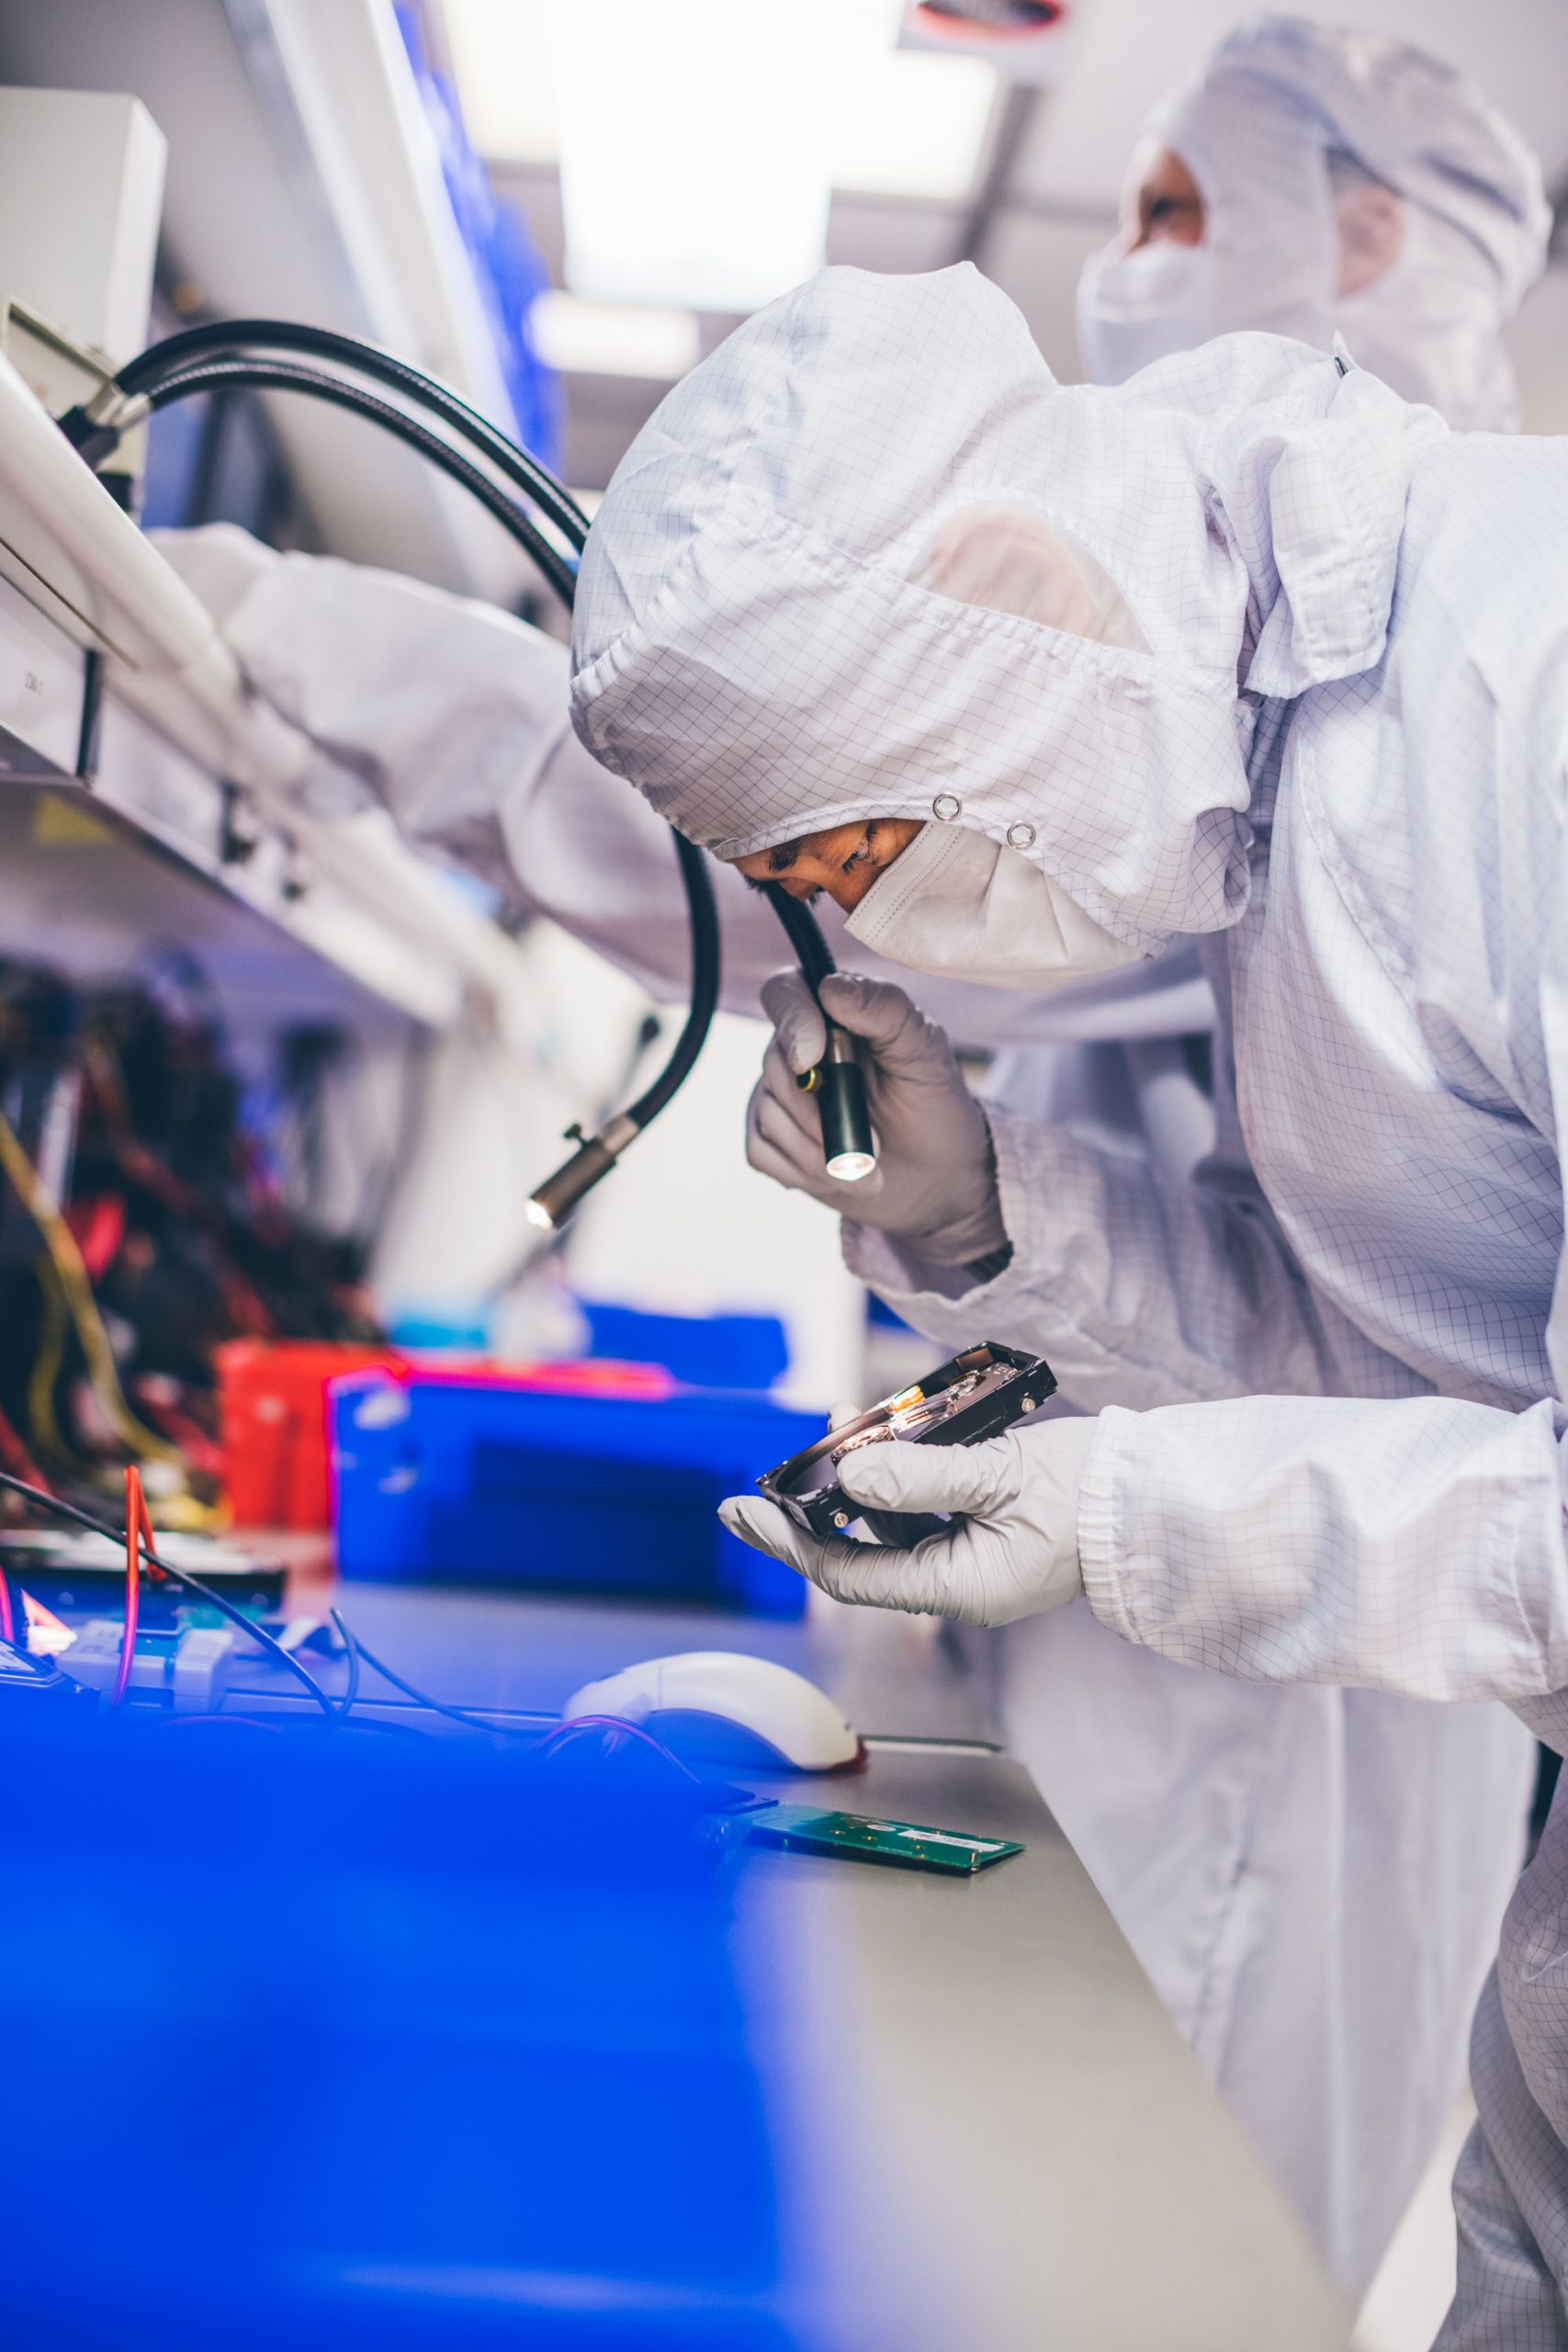
Anche con una pianificazione accurata, i guasti accadono. Quando succede, è fondamentale rivolgersi a professionisti esperti prima di intraprendere qualsiasi azione. Per quanto solido possa essere il tuo piano di disaster recovery, il supporto professionale può fare la differenza tra un'interruzione temporanea e una perdita permanente.
DriveSavers è da decenni un nome di fiducia nei servizi professionali di recupero dati. Siamo specializzati nei servizi di recupero dati RAID, e ci occupiamo di tutto, dai semplici array mirror RAID 1 ai RAID 50 su scala aziendale e oltre. Abbiamo recuperato dati da server danneggiati dal fuoco, dischi inzuppati d'acqua e collassi totali di array. I nostri ingegneri lavorano in camere bianche certificate con strumenti proprietari per recuperare i tuoi dati in sicurezza, anche quando altri fornitori dicono che non si può fare.
Considerazioni finali: sistemi in ordine, coscienza a posto
La primavera è un periodo di rinnovamento, e anche il tuo array RAID merita lo stesso nuovo inizio. Trascurare la manutenzione RAID aumenta notevolmente il rischio di perdita di dati, qualcosa che nessuna azienda può permettersi. Approfitta di questa occasione per riprendere in mano la tua checklist di manutenzione dei server, convalidare i tuoi sistemi di backup e valutare lo stato di salute del tuo RAID.
I sistemi RAID possono essere progettati per la resilienza, ma non sono invincibili. Una manutenzione RAID regolare è uno degli investimenti più intelligenti che tu possa fare per proteggere i tuoi dati, e la tua azienda, da guasti evitabili.
E se il disastro dovesse comunque verificarsi? DriveSavers è sempre qui per aiutarti a recuperare ciò che conta di più. Contattaci per soluzioni professionali di recupero dati e riavere i tuoi file in modo rapido e sicuro.

 English (United States)
 English (Australia)
 French (France)
 English (UK)
 French (Canada)
 English (Canada)
 Spanish (Mexico)
 German
 Dutch
 Italian
 Finnish
 Polish
 Norwegian
 Swedish
 Danish
 Spanish (Spain)
 Chinese
 Japanese
 German (Austria)