

Vårstart för RAID-underhåll: förebygg RAID-fel med en checklista för serverunderhåll

När årstiderna skiftar är det ett perfekt tillfälle att fräta upp inte bara din omgivning utan också din it-infrastruktur. Vårstädning är inte begränsad till fysiska utrymmen – den är lika viktig för dina digitala system. Regelbundet RAID-underhåll kan bidra till att förebygga oväntade driftstopp, minska kostnaderna på lång sikt och skydda din organisation från förödande RAID-fel.
När ditt RAID-system fungerar som det ska är det lätt att glömma att det alls finns. Men precis som alla affärskritiska system behöver det regelbunden uppmärksamhet. Att tillämpa en strukturerad checklista för serverunderhåll i vår är ett smart, proaktivt steg för att undvika kostsamma avbrott.
RAID-underhållets roll för att förebygga katastrofer
RAID-system (Redundant Array of Independent Disks, alltså redundant uppsättning oberoende diskar) används flitigt för sin snabbhet och redundans. Men de är inte immuna mot fel. Utan löpande RAID-underhåll kan även de mest robusta konfigurationerna försämras med tiden, vilket leder till sjunkande serverprestanda eller totala arrayfel.
RAID-system kan dölja diskfel en tid genom att köra i degraderat läge utan varning. Denna tysta försämring blir ofta kritisk först när det är för sent: när en andra disk går sönder, en styrenhet fallerar eller systemet kraschar helt. Utan åtgärder kan dessa problem eskalera till ett fullskaligt systemfel som orsakar omfattande driftstopp. Förebyggande underhåll hjälper till att upptäcka och åtgärda problem innan de skenar iväg.
Kärnelementen i en checklista för serverunderhåll
En heltäckande checklista för serverhantering och serverunderhåll bör innehålla rutinkontroller av både hårdvara och programvara. Följande uppgifter är avgörande för att skydda ditt RAID-system:
Övervaka RAID-diskarnas hälsa
Använd diagnostikverktyg för att utvärdera diskprestandan i hela arrayen. Håll utkik efter tidiga tecken på fel, som förseningar vid ombyggnad eller försämring av diskarna.
Utför regelbundna tester av säkerhetskopior
Utgå aldrig från att säkerhetskopiorna fungerar. Utför regelbundna återställningstester för att bekräfta att sparad data faktiskt går att återställa när den behövs.
Uppdatera fast programvara och styrenheter
Håll den fasta programvaran i RAID-styrenheten och diskarnas programvara uppdaterad. Gammal fast programvara kan orsaka kompatibilitetsproblem eller lämna kritiska buggar olösta.
Upprätthåll en idealisk servermiljö
Se till att serverrum uppfyller miljöstandarderna. Överhettning, dammansamling eller dåligt luftflöde kan med tiden minska hårdvarans tillförlitlighet.
Granska loggar och dokumentation
Dokumentera alla RAID-ändringar, diskbyten och felloggar. Korrekta uppgifter kan avsevärt förbättra felsökning och framtida återställningsinsatser.
| Underhållsuppgift | Vad som ska kontrolleras | Föreslagen frekvens* |
|---|---|---|
| RAID-arrayens hälsa | Leta efter degraderade diskar, felande arrayer och problem med ombyggnad | Dagligen / Varje vecka |
| Uppdateringar av fast programvara och programvara | RAID-styrenhet, diskarnas fasta programvara, hanteringsverktyg | Vid behov |
| Verifiering av säkerhetskopior | Testa återställningspunkter, kontrollera loggar för säkerhetskopieringsjobb | Varje vecka / Varje månad |
| Miljöförhållanden | Temperatur, damm, luftflöde, strömförsörjningens stabilitet | Varje månad |
| Granskning av loggar och dokumentation | Diskfel, ombyggnadshistorik, konfigurationsändringar | Dagligen / Varje vecka |
*De angivna frekvenserna är allmänna rekommendationer. Varje miljö är unik – anpassa den här checklistan efter din datavolym, hur kritiska dina system är och din riskprofil.
Ett verkligt exempel på RAID-fel
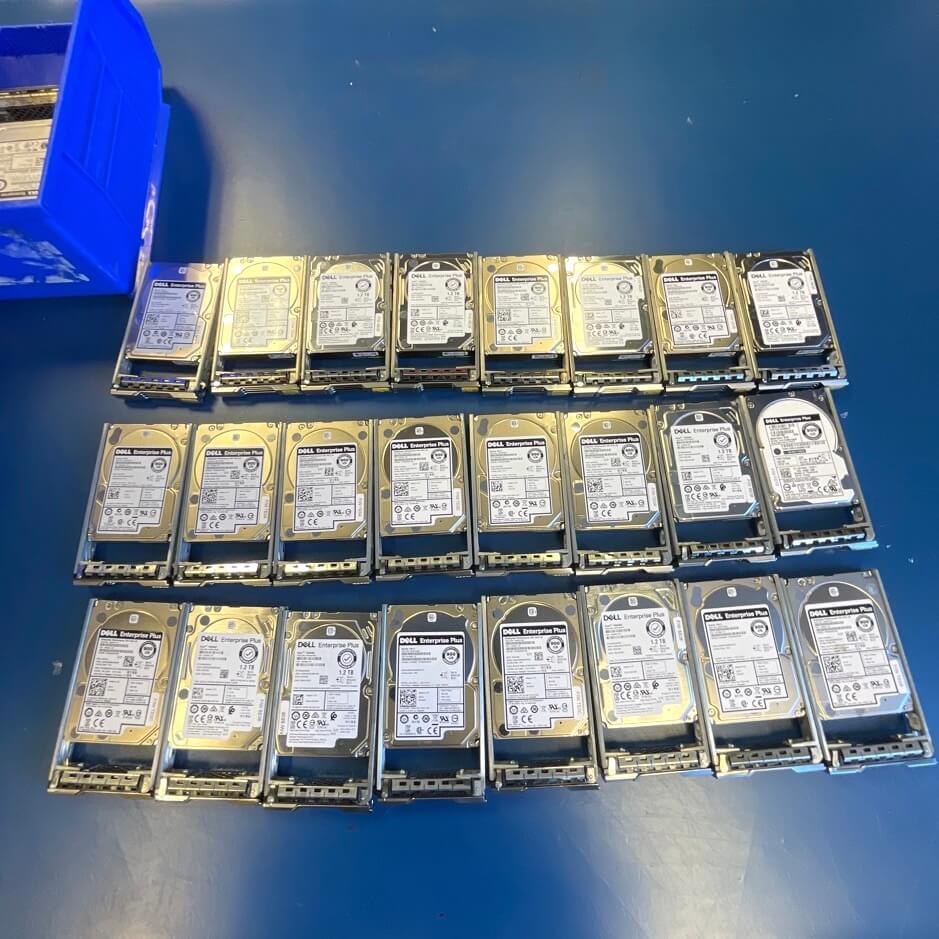
Strömfluktuationer eller strömavbrott kan leda till dataskador, diskförsämring eller till och med att hela servern kraschar.
Ta fallet med en klädbutik som drabbades av flera hårddiskfel efter ett strömavbrott. Deras Dell EqualLogic-system, som bestod av 44 diskar i en komplex RAID 50-konfiguration, drabbades av katastrofal dataförlust på grund av att flera diskar havererade samtidigt.
DriveSavers kallades in för att återställa datan. Ingenjörerna utvecklade skräddarsydda verktyg för att tolka och rekonstruera systemets unika struktur och lyckades återställa merparten av butikens kritiska data.
Även om det här fallet fick ett positivt utfall är det en tydlig påminnelse: RAID-fel kan slå till snabbt, särskilt när systemen är sårbara. I det här fallet hade regelbundet RAID-underhåll kunnat minska risken avsevärt.
Hur underhåll kunde ha gjort skillnad
Låt oss gå igenom hur utfallet kunde ha förändrats med en proaktiv underhållsstrategi:
Kort sagt är RAID-fel sällan ett enpunktsfel. Det är oftast en kedja av små problem som förblir obemärkta tills en yttre utlösare, som ett strömavbrott, driver systemet över kanten.
Vanliga misstag vid RAID-underhåll att undvika
Även erfarna it-team kan förbise bästa praxis för RAID. Dessutom fortsätter RAID-arrayer ofta att köra efter ett eller flera hårdvarufel, vilket döljer systemets verkliga tillstånd. En enda disk som havererar behöver inte slå ut systemet direkt, men den ökar risken för en kaskad av diskfel i hela arrayen.
Här är några vanliga misstag som ofta leder till problem:
Om det havererar, ring experterna
Även med noggrann planering inträffar fel. När de gör det är det avgörande att kontakta erfarna yrkespersoner innan du vidtar några åtgärder. Oavsett hur solid din katastrofåterställningsplan är kan professionellt stöd göra skillnaden mellan ett tillfälligt avbrott och en permanent förlust.
DriveSavers har i decennier varit ett pålitligt namn inom professionella dataåterställningstjänster. Vi är specialiserade på RAID-dataåterställningstjänster och hanterar allt från enkla RAID 1-spegelarrayer till RAID 50 i företagsskala och mer därtill. Vi har återställt data från brandskadade servrar, vattendränkta diskar och totalt kollapsade arrayer. Våra ingenjörer arbetar i certifierade renrum med proprietära verktyg för att säkert återställa din data – även när andra leverantörer säger att det inte går.
Avslutande tankar: rena system, rent samvete
Våren är en tid för förnyelse – och ditt RAID förtjänar samma nystart. Att hoppa över RAID-underhåll ökar risken för dataförlust avsevärt, något inget företag har råd med. Ta tillfället i akt att återuppta din checklista för serverunderhåll, validera dina säkerhetskopieringssystem och bedöma ditt RAID-systems hälsa.
RAID-system kan vara byggda för att tåla mycket, men de är inte oövervinnerliga. Regelbundet RAID-underhåll är en av de smartaste investeringarna du kan göra för att skydda din data, och ditt företag, mot undvikbara fel.
Och om katastrofen ändå inträffar? DriveSavers finns alltid här för att hjälpa dig återställa det som betyder mest. Kontakta oss för professionella dataåterställningslösningar och få tillbaka dina filer snabbt och säkert.

 English (United States)
 English (Australia)
 French (France)
 English (UK)
 French (Canada)
 English (Canada)
 Spanish (Mexico)
 German
 Dutch
 Italian
 Finnish
 Polish
 Norwegian
 Swedish
 Danish
 Spanish (Spain)
 Chinese
 Japanese
 German (Austria)